
eval_carrace_maps_ep1000_new_seedNone_style_default_40000_h200_ppo_new_default
收藏数据链接:
官方服务:
资源简介:
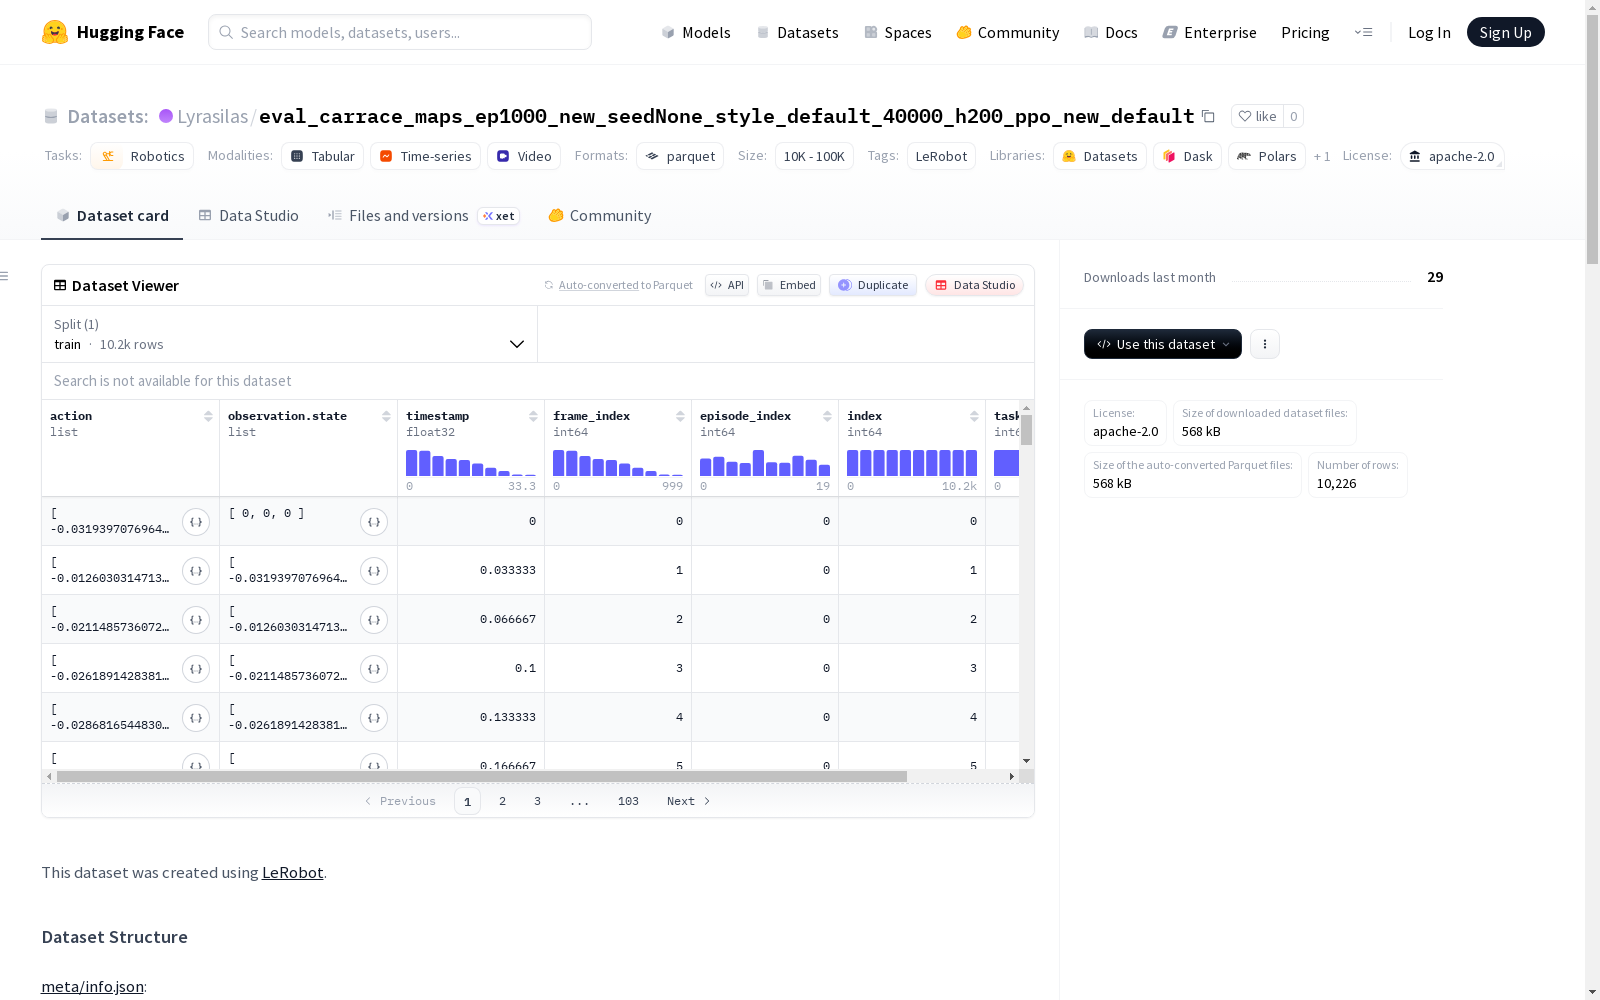
该数据集是使用LeRobot创建的,适用于机器人技术领域。数据集采用Apache-2.0许可证。数据集结构包括5个总剧集,1733个总帧数,1个总任务,5个总视频和1个总块。数据以30帧每秒的速率采集。数据集包含多个特征,如动作(包括转向位置、油门位置和刹车位置)、观察状态(与动作相同的特征)、观察图像(前端图像,分辨率为192x160,3通道)、时间戳、帧索引、剧集索引、索引和任务索引。数据文件以parquet格式存储,视频文件以mp4格式存储。数据集适用于机器人控制、自动驾驶等任务的研究和开发。
创建时间:
2026-02-13
原始信息汇总
数据集概述
基本信息
- 数据集名称: eval_carrace_maps_ep1000_new_seedNone_style_default_40000_h200_ppo_new_default
- 创建工具: LeRobot (https://github.com/huggingface/lerobot)
- 许可协议: Apache-2.0
- 任务类别: 机器人学
数据集结构
- 总任务数: 1
- 总回合数: 5
- 总帧数: 1733
- 总视频数: 5
- 数据块数: 1
- 数据块大小: 1000
- 帧率: 30 FPS
- 数据格式: Parquet
- 数据路径模式:
data/chunk-{episode_chunk:03d}/episode_{episode_index:06d}.parquet - 视频路径模式:
videos/chunk-{episode_chunk:03d}/{video_key}/episode_{episode_index:06d}.mp4 - 数据划分: 训练集 (索引 0 至 5)
特征字段
- action:
- 数据类型: float32
- 形状: [3]
- 含义: ["steering.pos", "throttle.pos", "brake.pos"]
- observation.state:
- 数据类型: float32
- 形状: [3]
- 含义: ["steering.pos", "throttle.pos", "brake.pos"]
- observation.images.front:
- 数据类型: video
- 形状: [192, 160, 3]
- 维度含义: ["height", "width", "channels"]
- 视频信息:
- 高度: 192 像素
- 宽度: 160 像素
- 编码: av1
- 像素格式: yuv420p
- 是否为深度图: 否
- 帧率: 30 FPS
- 通道数: 3
- 包含音频: 否
- timestamp:
- 数据类型: float32
- 形状: [1]
- frame_index:
- 数据类型: int64
- 形状: [1]
- episode_index:
- 数据类型: int64
- 形状: [1]
- index:
- 数据类型: int64
- 形状: [1]
- task_index:
- 数据类型: int64
- 形状: [1]
元数据
- 代码库版本: v2.1
- 机器人类型: racecar
引用信息
- 主页: [More Information Needed]
- 论文: [More Information Needed]
- BibTeX 引用: [More Information Needed]
搜集汇总
数据集介绍
构建方式
在机器人学领域,数据驱动的决策模型日益成为研究焦点,eval_carrace_maps_ep1000_new_seedNone_style_default_40000_h200_ppo_new_default数据集正是基于这一背景构建的。该数据集依托LeRobot开源框架,通过模拟赛车环境收集了5个完整的情节,总计1733帧数据,并以30帧每秒的速率记录。数据以Parquet格式分块存储,每块包含1000帧,确保了高效的数据管理与访问。其构建过程整合了动作指令、状态观测与视觉信息,为强化学习算法的训练与评估提供了结构化支持。
特点
该数据集在机器人控制领域展现出独特的数据特征,其核心在于多维度的观测与动作表示。数据集不仅包含了赛车的前置摄像头图像,分辨率为192x160像素,还精确记录了转向、油门与刹车的位置状态,形成三维动作向量。时间戳与帧索引的纳入使得时序分析成为可能,而任务与情节索引的标注则支持了多任务学习场景的构建。这种融合视觉与状态信息的结构,为端到端控制策略的研发提供了丰富且一致的输入输出对。
使用方法
针对机器人学习的研究需求,该数据集的使用方法注重于数据的可访问性与可扩展性。用户可通过LeRobot框架直接加载数据,利用其预定义的特征结构进行模型训练,尤其是在强化学习中的策略优化方面。数据的分块存储设计允许按需读取,减少了内存负担,而视频与特征数据的并行可用性则支持了视觉模仿学习与行为克隆等任务。研究人员可依据提供的元数据信息,灵活划分训练集,以验证算法在动态环境中的泛化能力。
背景与挑战
背景概述
在机器人学习领域,自动驾驶小车(racecar)的控制策略研究一直是推动强化学习与视觉感知融合的前沿课题。eval_carrace_maps_ep1000_new_seedNone_style_default_40000_h200_ppo_new_default数据集由HuggingFace的LeRobot项目团队构建,旨在为基于视觉的端到端自动驾驶策略评估提供标准化基准。该数据集通过采集真实或仿真环境中的驾驶序列,整合了前视摄像头图像、车辆状态(如转向、油门、刹车位置)及时间戳等多模态数据,为研究者在复杂动态场景下验证强化学习算法的泛化能力与鲁棒性提供了关键资源。其设计反映了当前机器人学中数据驱动方法对高维感知与连续控制联合优化的迫切需求。
当前挑战
该数据集致力于解决视觉导航与连续控制决策的协同挑战,其核心问题在于如何从高维图像输入中提取有效特征,并映射至精确的车辆动作序列,以应对赛道环境的动态变化与不确定性。在构建过程中,数据采集面临传感器同步、多模态数据对齐以及大规模序列存储的技术难题;同时,仿真环境与真实物理世界存在的域差异,可能导致策略迁移时的性能衰减。此外,数据集的规模与多样性有限,可能制约了模型在更广泛场景下的泛化能力评估。
常用场景
经典使用场景
在机器人学与自动驾驶领域,仿真环境下的赛车控制任务常被用作验证强化学习算法的关键平台。该数据集通过记录赛车在虚拟赛道中的驾驶数据,包括前视图像、转向、油门和刹车动作,为研究者提供了丰富的离线训练资源。经典使用场景涉及基于视觉的端到端驾驶策略学习,模型通过观察图像序列直接预测控制指令,从而模拟人类驾驶员的决策过程。这种场景不仅考验算法的感知与决策能力,还推动了在复杂动态环境中稳健控制方法的发展。
解决学术问题
该数据集主要针对机器人控制中的模仿学习与离线强化学习问题,为解决从高维视觉输入到连续动作空间的映射挑战提供了实证基础。它帮助研究者探索如何从有限的演示数据中提取有效策略,减少对昂贵在线交互的依赖,并促进样本效率的提升。在学术意义上,该数据集支持了视觉-动作耦合建模的研究,为自动驾驶系统的安全验证与策略泛化提供了基准测试环境,推动了数据驱动控制理论在现实约束下的应用进展。
衍生相关工作
围绕该数据集衍生的经典工作主要集中在视觉强化学习与行为克隆领域。例如,基于LeRobot框架的研究者开发了高效的策略蒸馏方法,将大规模仿真数据转化为可部署的控制模型。相关研究还探索了多任务学习与迁移学习技术,利用赛车数据提升其他机器人平台的适应性。这些工作不仅扩展了数据集的学术价值,还催生了开源工具链的优化,促进了社区在仿真到现实迁移问题上的协作创新。
以上内容由遇见数据集搜集并总结生成


