遇见数据集

handshake-ai-research/bankertoolbench

收藏
Hugging Face2026-06-05 更新2026-05-10 收录
官方服务:

资源简介:

BankerToolBench是一个包含100个端到端投资银行任务的基准测试,用于评估AI代理。每个任务模拟真实的初级银行家工作——包括构建金融模型、准备推介演示文稿、撰写备忘录——并产生多文件交付物(如Excel、PowerPoint、Word),这些交付物会根据专家制定的评分标准进行评分。该基准测试由来自高盛、摩根大通、Evercore等公司的502名投资银行家共同开发,每个任务的平均人工完成时间为5小时(最长可达21小时),每个任务的平均评分标准为150项。

BankerToolBench is a benchmark of 100 end-to-end investment banking tasks for evaluating AI agents. Each task mirrors real junior-banker work — building financial models, preparing pitch decks, writing memos — and produces multi-file deliverables (Excel, PowerPoint, Word) that are scored against expert-authored rubrics. The benchmark was developed with 502 investment bankers from firms including Goldman Sachs, JPMorgan, Evercore, and others. Human completion time averages 5 hours per task (up to 21 hours), and rubrics average 150 criteria per task.
提供机构:
handshake-ai-research
搜集汇总
数据集介绍
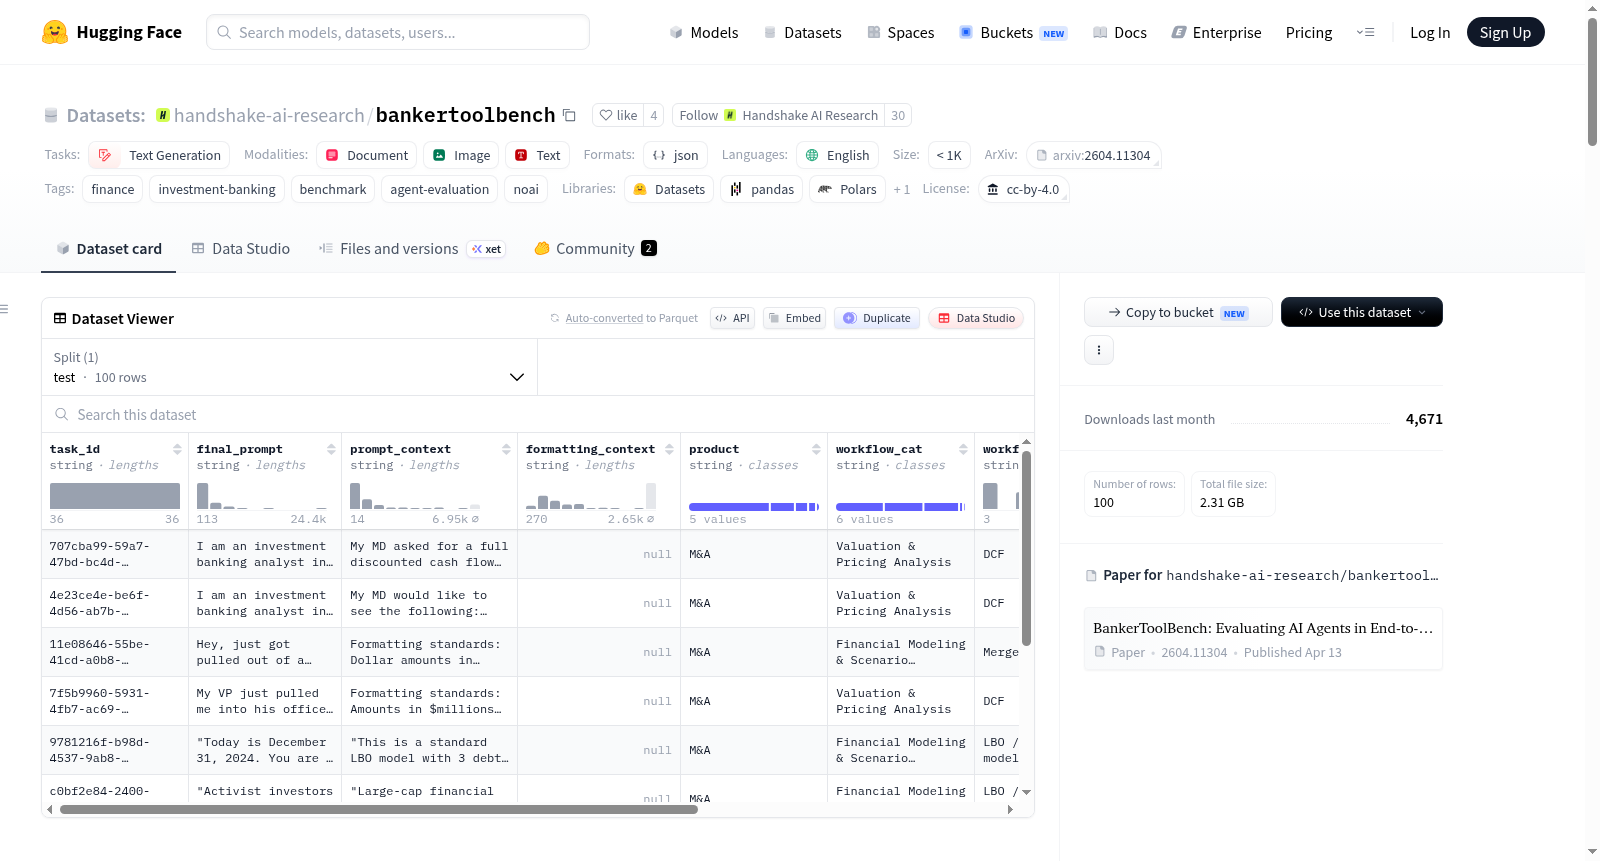
handshake-ai-research/bankertoolbench 数据集图片
构建方式
BankerToolBench是一个专为评估AI智能体在投资银行业务中表现而设计的基准测试,其构建过程凝聚了来自高盛、摩根大通、Evercore等知名投行502位从业者的集体智慧。该基准精心设计了100项端到端任务,每项任务均模拟初级银行家的真实工作场景,涵盖财务模型构建、路演材料准备与备忘录撰写等核心环节,要求AI智能体产出包含Excel、PowerPoint和Word在内的多文件交付物。每一份交付物的评分标准均由资深专家制定,平均每项任务包含150条细致入微的评估准则,人类完成单个任务的平均耗时约5小时,部分复杂任务甚至可达21小时,确保了评估的严谨性与现实相关性。
特点
该数据集的核心特色在于其高度专业化与真实性的融合。BankerToolBench不仅涵盖了债务资本市场、股权资本市场、杠杆融资与并购四大投行产品组,还细分为多个工作流类别与子类别,形成了层次分明的任务体系。每项任务均配备了详尽的元数据,包括唯一标识符、核心指令、背景信息以及结构化的评估量表,其中权重与类别的赋予使得评分过程兼具量化精确性与行业洞察力。此外,数据集还提供了由资深银行家制作的标准参考输出,作为评判AI智能体表现的金标准,同时内置了用于防范数据泄露的激活码字符串,体现了对基准测试纯净性的严格把控。
使用方法
使用BankerToolBench评估AI智能体时,研究者需首先通过HuggingFace数据集接口加载包含100项任务元数据的tasks.jsonl文件,并依据每项任务的final_prompt字段向智能体发出核心指令。智能体在执行任务过程中,可访问位于shared-tools目录下的三大金融数据源:SEC EDGAR数据库收录了约690家美国上市公司的公开文件,虚拟数据室提供了市场数据API接口以获取财务与股价信息,公司标识库则支持企业图形资料的检索。完成操作后,智能体产出的多格式交付物将依据对应的aggregated_rubric_json评估量表进行自动化评分,研究者还可利用GitHub仓库中的强化学习环境进行策略优化与结果复现,从而系统性地衡量AI在真实投行工作流中的效能边界。
背景与挑战
背景概述
BankerToolBench是由Handshake AI Research团队联合高盛、摩根大通、Evercore等顶级投行的502位投资银行专家于2026年发布的基准测试数据集,旨在评估AI代理在端到端投资银行工作流中的能力。该数据集聚焦于模拟初级银行家的核心任务,包括构建财务模型、准备路演材料、撰写备忘录等,其每项任务平均耗时人类专家5小时(最长可达21小时),并依据专家制定的平均包含150条评分标准的细粒度评分表进行多维评估。作为金融领域AI评估的重要里程碑,BankerToolBench填补了现有基准难以捕捉投资银行复杂工作流与专业交付成果的空白,为衡量大语言模型在金融实操中的适用性提供了高保真、可量化的测试平台。
当前挑战
该数据集所解决的领域问题在于,投资银行工作高度依赖多步骤推理、多文件产出(Excel、PowerPoint、Word)及对金融专业知识的精准运用,而现有AI基准往往局限于单轮问答或简单代码生成,无法评估代理在真实投行场景中的端到端执行能力。构建过程中,研究团队面临双重挑战:一是任务设计需确保100项任务覆盖DCM、ECM、杠杆融资、并购等核心产品组,并保证每个任务具备可自动评分的结构化评估准则;二是数据来源涉及SEC EDGAR数据库(约690家美国上市公司文件)、虚拟数据室等海量金融信息,需在保护隐私前提下提供标准化接口,同时避免基准数据泄露至训练语料库中,以确保评估的公正性与可重复性。
常用场景
经典使用场景
BankerToolBench作为一个专注于投资银行领域的智能体评估基准,其最经典的用途在于衡量AI系统在端到端投行工作流中的综合表现。该数据集精心设计了100个模拟初级投行分析师日常工作的任务,涵盖财务模型构建、路演材料准备、备忘录撰写等核心场景,要求AI代理生成包含Excel、PowerPoint和Word在内的多文件交付物。通过专家设计的详细评分标准,研究者能够系统性地评估AI在复杂金融任务中的准确性、逻辑性和专业性,为金融领域大语言模型和智能体的能力边界探索提供了标准化的测试平台。
解决学术问题
该数据集有效解决了学术界长期面临的金融领域AI评估缺乏真实性和复杂性的困境。传统评估多依赖于简化的问答或文档理解任务,难以反映投行工作中多步骤推理、跨文档协作和领域知识运用的真实挑战。BankerToolBench通过引入502位来自高盛、摩根大通等顶级投行专家参与构建的高质量标准,为研究金融智能体的任务规划能力、工具使用效率和输出质量提供了可靠基准。它的出现推动了AI在专业金融服务领域的能力度量从概念验证阶段迈向了可量化、可复现的严谨评估范式,对理解大语言模型的推理深度和领域适应性具有深远意义。
衍生相关工作
BankerToolBench的推出激发了金融AI领域多项衍生性研究工作。基于该基准的高质量评分标准和专家交付物,研究者开发了针对金融文档生成的精细化评估方法,探索如何将逐条评分标准转化为可自动计算的奖励信号。该数据集提供的SEC文件数据库、市场数据和公司信息查询工具,启发了面向金融领域的检索增强生成系统设计,推动了专用金融工具链的研发。更重要的是,其公开的强化学习环境促使多个团队开展基于过程的监督微调研究,通过将复杂的投行任务分解为可学习的子步骤,显著提升了AI在长链条、多模态输出任务中的表现,为金融智能体的学术探索开辟了新方向。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务