
saarus72/ficbook_text_norm
收藏官方服务:
资源简介:
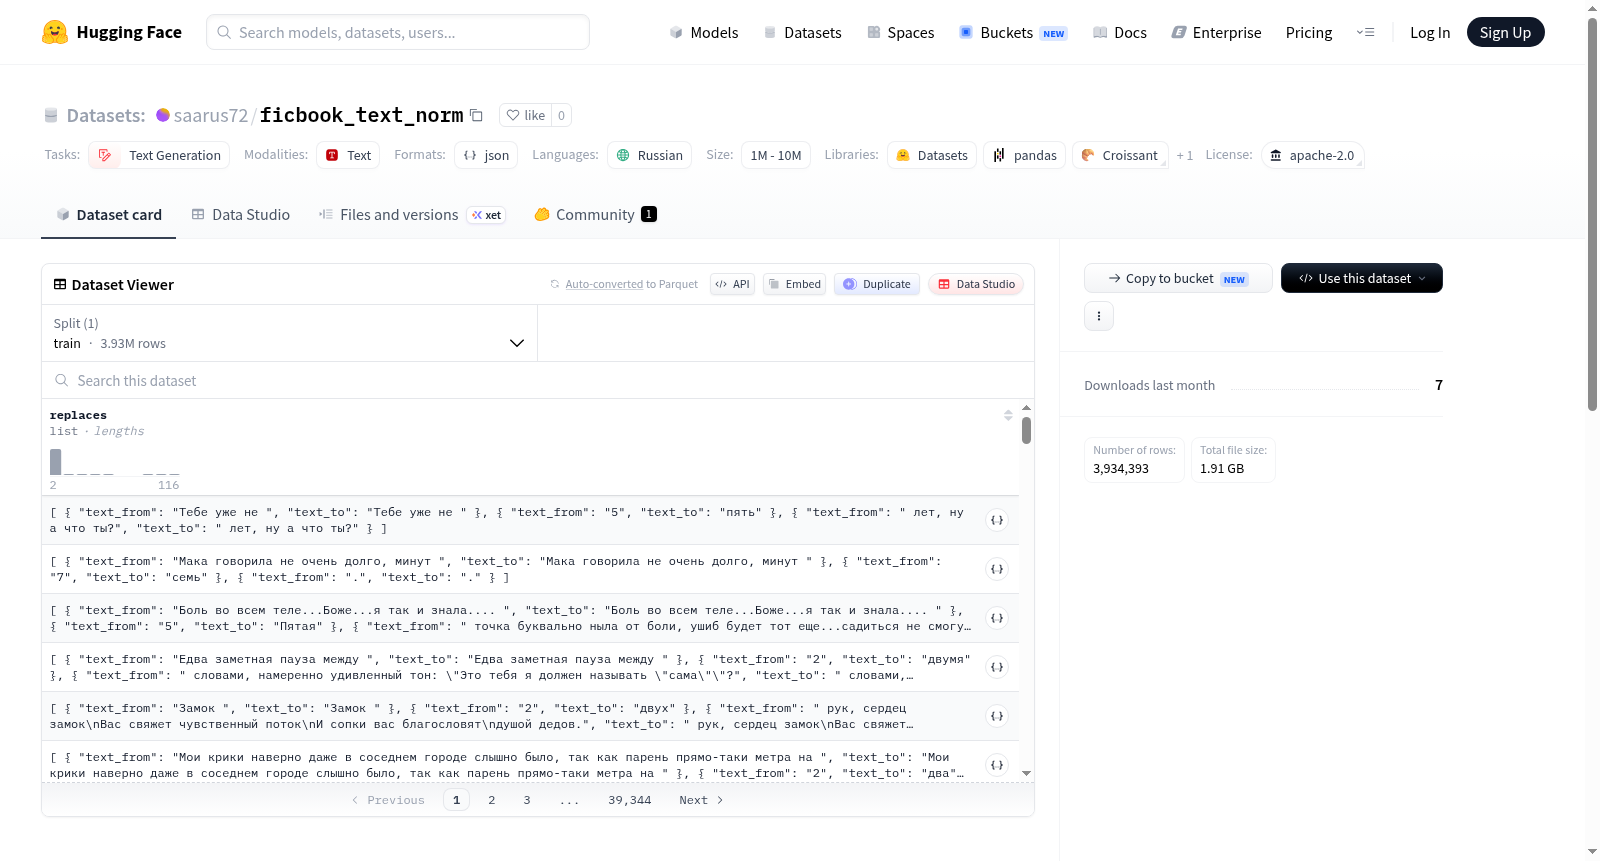
该数据集包含从ficbook数据集中获取的文本,经过逆向归一化处理。归一化处理使用了特定的笔记本,并最终存储为一个jsonl文件。文件中每一行包含多个替换对,展示了从原始文本到归一化文本的转换。
该数据集包含从ficbook数据集中获取的文本,经过逆向归一化处理。归一化处理使用了特定的笔记本,并最终存储为一个jsonl文件。文件中每一行包含多个替换对,展示了从原始文本到归一化文本的转换。
提供机构:
saarus72原始信息汇总
数据集概述
许可证
- Apache 2.0
任务类别
- 文本生成
语言
- 俄语
数据集大小
- 1M<n<10M
数据格式
- 数据集以
jsonl格式存储,每行包含一个JSON对象,该对象包含一系列替换对,每个替换对包含原始文本和替换后的文本。
示例数据
json { "replaces": [ { "text_from": "Боль во всем теле...Боже...я так и знала.... ", "text_to": "Боль во всем теле...Боже...я так и знала.... " }, { "text_from": "5", "text_to": "Пятая" }, { "text_from": " точка буквально ныла от боли, ушиб будет тот еще...садиться не смогу дня ", "text_to": " точка буквально ныла от боли, ушиб будет тот еще...садиться не смогу дня " }, { "text_from": "3", "text_to": "три" }, { "text_from": " так, точно.", "text_to": " так, точно." } ] }
搜集汇总
数据集介绍
构建方式
该数据集源自俄语同人小说平台ficbook的原始语料库,通过逆规范化处理技术构建而成。具体而言,研究者利用个人开发的俄语文本规范化模型,基于公开的规范化笔记本工具,对原始文本中数字、缩写等非标准表达进行系统性还原,生成原始形式与规范化形式之间的映射关系。最终将所有转换记录整合为单一的JSONL格式文件,每条数据包含多个替换对,清晰呈现了原始文本片段与对应规范化文本的对应关系。
特点
该数据集的核心特点在于其逆规范化的设计理念,不同于常见的文本规范化任务,它专注于提供非标准表达到标准形式的转换实例。数据规模超过百万条,覆盖了俄语同人小说中丰富的口语化、网络用语及数字表达等多样化场景。每条记录以替换对形式存储,保留了原始上下文的完整性,为训练文本规范化或逆规范化模型提供了高质量的平行语料。
使用方法
该数据集适用于文本生成与自然语言处理中的规范化任务,特别是针对俄语非标准文本的处理。研究者可直接加载JSONL文件,利用其中的替换对构建训练样本,用于训练序列到序列模型或基于规则的规范化系统。数据集已托管于HuggingFace平台,支持通过datasets库便捷调用,亦可结合配套的规范化模型与演示空间进行效果验证与二次开发。
背景与挑战
背景概述
该数据集由 saarus72 于近期创建,源自俄语网络文学平台 ficbook 上的大规模文本语料库,旨在解决俄语文本逆规范化(inverse normalization)这一自然语言处理中的关键问题。研究团队通过自主开发的文本规范化工具,将原始的非规范表达(如数字、缩写、口语化拼写)转换为标准书面形式,进而构建了包含数百万条替换对的高质量数据集。这一工作不仅为俄语文本生成与理解任务提供了宝贵的训练资源,更推动了低资源语言在文本规范化领域的研究进展,尤其对社交网络文本、用户生成内容等非正式语体的处理具有重要示范意义。
当前挑战
当前数据集面临的核心挑战在于领域问题的复杂性:俄语文本逆规范化需同时处理数字、缩写、谐音词、表情符号等多种非规范形式,且不同语境下的转换规则存在模糊性,例如数字“5”可能需转换为“пятая”(第五)或“пять”(五),依赖上下文语义。构建过程中,团队需应对原始语料中噪声干扰(如拼写错误、混合语言片段),并设计高效的标注策略以平衡人工成本与数据质量。此外,模型在跨领域(如新闻、对话)的泛化能力尚未验证,现有替换对可能隐含文化特异性表达,限制了其在通用场景中的适用性。
常用场景
经典使用场景
该数据集源自俄语同人小说社区ficbook的原始文本,经过逆归一化处理,旨在为俄语文本规范化模型提供训练与评估的基准。其经典使用场景聚焦于文本生成任务中的数字、缩写及特殊符号的语义还原,通过将非标准书写形式(如“5”转换为“Пятая”)映射为符合语言规范的表达,从而提升生成文本的自然度与可读性。这一过程对于俄语自然语言处理中语法与拼写的一致性校正具有奠基性意义。
解决学术问题
在学术研究层面,该数据集有效解决了俄语非正式文本中普遍存在的书写不一致问题,尤其是数字与字母混用、缩略语歧义等对下游任务造成的干扰。通过提供成对的原始文本与规范化文本,它支持研究者量化评估不同规范化策略的精度与召回率,推动了俄语文本预处理技术的标准化进程。其贡献在于为低资源语言的文本规范化研究树立了可复现的基准,并揭示了非正式语域中语言变异的规律。
衍生相关工作
基于该数据集,衍生出多项经典工作,包括saarus72开源的俄语文本规范化模型(russian_text_normalizer)及其配套的Jupyter Notebook处理管线。该模型在HuggingFace模型库中公开,并作为独立Space应用上线,形成了从数据构建到模型推理的完整闭环。后续研究进一步将其扩展至多领域文本(如新闻与对话)的跨域规范化,验证了数据集的泛化能力,并催生了针对俄语拼写错误矫正的联合学习框架。
以上内容由遇见数据集搜集并总结生成


