
swaroop-nath/opin-pref
收藏官方服务:
资源简介:
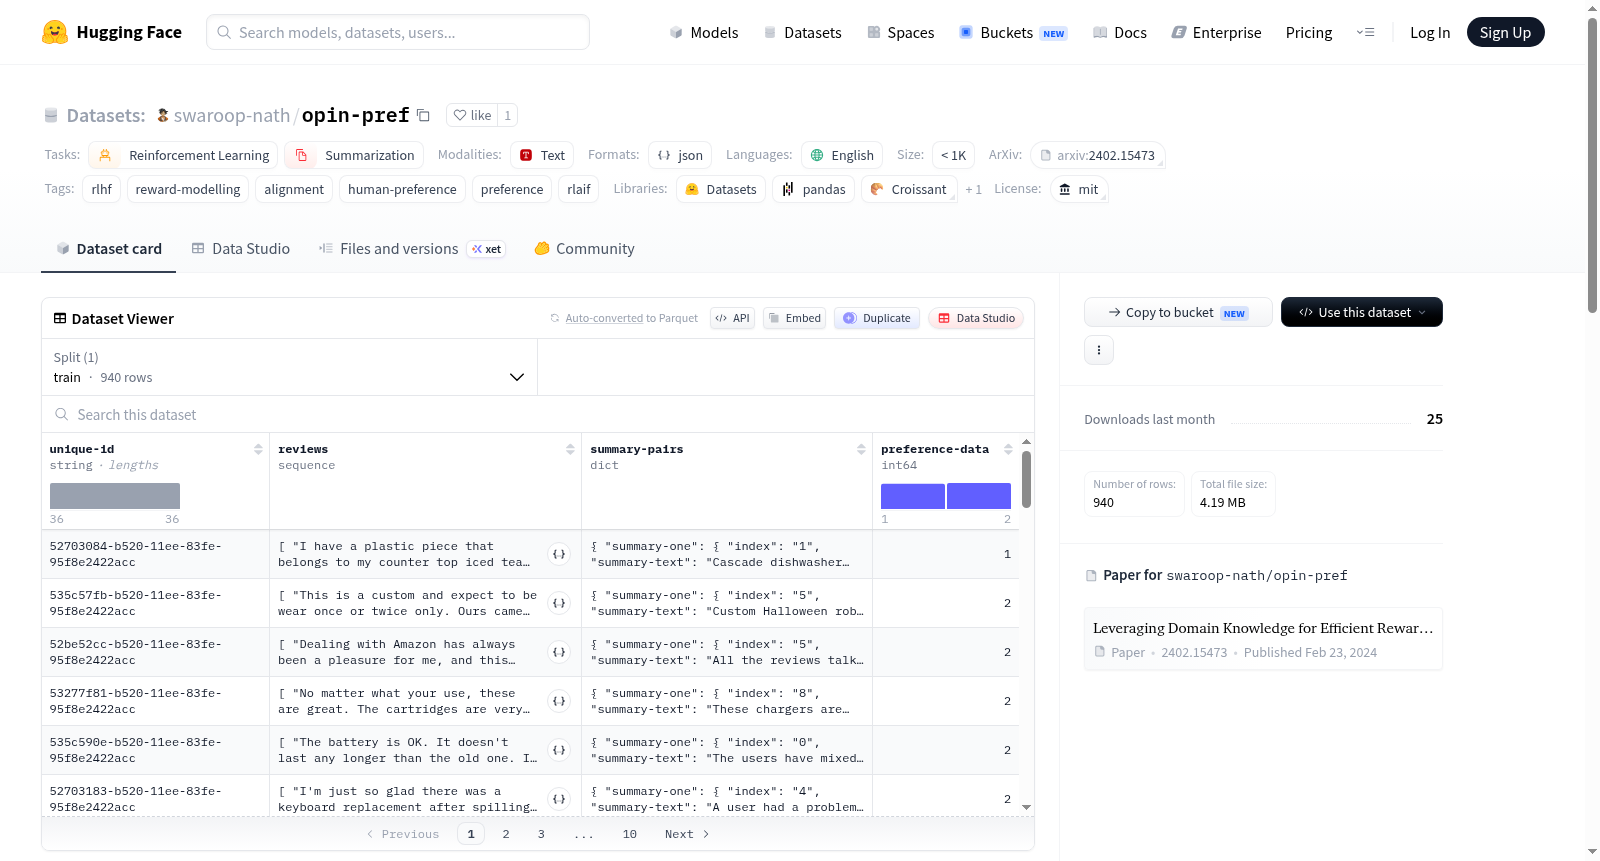
opin-pref数据集是一个用于意见摘要的人类偏好数据集,包含940个实例。每个实例包括一组评论、两个观点摘要以及由领域专家收集的人类偏好。数据集以jsonl格式存储,便于分析和处理。
opin-pref数据集是一个用于意见摘要的人类偏好数据集,包含940个实例。每个实例包括一组评论、两个观点摘要以及由领域专家收集的人类偏好。数据集以jsonl格式存储,便于分析和处理。
提供机构:
swaroop-nath原始信息汇总
数据集概述
基本信息
- 许可证: MIT
- 任务类别: 强化学习
- 语言: 英语
- 标签: rlhf, reward-modelling
- 美观名称: opin-pref
- 大小类别: n<1K
数据集描述
- 数据集类型: 人类偏好数据集,用于观点摘要。
- 数据实例: 每个实例包含评论、两个观点摘要和人类偏好。
- 数据来源: 偏好数据由领域专家收集。
- 数据总量: 940个实例。
- 数据格式: jsonl文件格式。
- 数据结构: json { "unique-id": "a unique id", "reviews": "list of reviews", "summary-pairs": "json object containing the summaries", "preference-data": "preference data gathered from humans" }
数据读取代码
- 编程语言: Python
- 读取函数: python def read_dataset(data_path: str) -> List[Dict]: with open(data_path, r) as file: lines = file.readlines() dataset = [json.loads(line) for line in lines] # requires the json library return dataset
基本统计信息
| 特征 | 值 |
|---|---|
| 评论中的单词数 | 641.21 |
| 评论数量 | 13.08 |
| 摘要中的单词数 | 73.16 |
| 偏好摘要中的单词数 | 85.41 |
| 非偏好摘要中的单词数 | 66.91 |
搜集汇总
数据集介绍
构建方式
在意见摘要领域,人类偏好的标注数据对于训练符合人类价值观的强化学习模型至关重要。opin-pref数据集正是为此而生,其构建过程严谨且专业。该数据集源自prompt-opin-summ数据集,从中精心选取了940个实例。每个实例均包含一组用户评论、两篇由不同模型生成的意见摘要,以及由领域专家提供的人类偏好标注。数据以JSONL格式存储,每一行是一个独立的JSON对象,包含唯一标识符、评论列表、摘要对以及偏好数据,便于程序化处理与复用。
特点
该数据集的核心特色在于其高质量的人类偏好标注,所有偏好均由领域专家直接给出,确保了标注的准确性与专业性。数据集规模虽小(不足1000条),但每条实例的信息密度高,平均包含约13条评论和73个词的摘要。特别值得注意的是,被偏好的摘要平均长度(85词)显著长于非偏好摘要(67词),暗示了在意见摘要任务中,更详尽的内容往往更受青睐。这种精细的统计特征为偏好学习研究提供了有价值的洞察。
使用方法
研究人员可通过Python标准库便捷地加载此数据集。首先使用open函数打开JSONL文件,随后通过列表推导式结合json.loads方法逐行解析,即可获得一个包含字典元素的列表,每个字典对应一条完整的实例。该数据集主要面向强化学习与奖励建模任务,尤其适用于RLHF(基于人类反馈的强化学习)和RLAIF(基于AI反馈的强化学习)方法。用户可直接利用其中的偏好三元组(评论、两篇摘要、偏好标签)来训练奖励模型或进行偏好对齐实验。
背景与挑战
背景概述
在自然语言处理领域,强化学习从人类反馈(RLHF)已成为对齐语言模型与人类偏好的关键技术。然而,在电子商务意见摘要这一细分任务中,获取高质量的人类偏好数据面临标注成本高昂与领域专家稀缺的双重困境。为此,Swaroop Nath等人于2024年提出了OpinPref数据集,旨在为意见摘要的奖励建模提供可靠的偏好基准。该数据集由来自学术界与工业界的多机构团队(包括印度理工学院、亚马逊等)联合构建,包含940个实例,每个实例由多用户评论、一对候选摘要及领域专家标注的偏好组成。其核心研究问题在于探索如何利用领域知识提高RLHF中奖励模型的样本效率,从而推动意见摘要系统在电商场景中的实用化。OpinPref的发布不仅为偏好学习提供了标准化测试床,更促进了RLHF在特定领域应用中的方法论创新。
当前挑战
OpinPref数据集所解决的领域问题在于,传统意见摘要的自动评估指标(如ROUGE)难以捕捉人类对摘要质量的主观偏好,而直接收集大规模人类反馈又受限于成本与一致性。具体挑战包括:1)偏好歧义性——不同专家对摘要质量的判断可能因视角差异而产生冲突,需要设计鲁棒的标注协议来降低噪声;2)样本稀缺性——仅940个标注实例难以覆盖电商评论中多样化的意见分布,导致模型泛化能力受限;3)构建过程中的平衡难题——需确保候选摘要对在质量上具有区分度,避免过于相似或明显优劣悬殊的案例,以提高偏好数据的信号强度;4)领域迁移风险——数据集源自特定电商场景,其偏好模式可能无法直接迁移至其他领域,需额外验证跨域适用性。这些挑战共同制约了基于偏好的意见摘要系统在实际部署中的可靠性。
常用场景
经典使用场景
在意见摘要生成领域,opin-pref数据集为基于人类偏好对齐的强化学习提供了关键的训练资源。该数据集精心收集了940条来自领域专家的偏好标注,每条实例包含多条用户评论、两篇候选摘要以及专家对摘要质量的明确偏好判断。研究者通常将其用于训练奖励模型,以捕捉人类对摘要质量的主观评价标准,进而优化摘要生成模型,使其输出更贴合真实用户的需求和期望。
解决学术问题
该数据集有效解决了意见摘要任务中奖励信号稀疏且难以定义的核心难题。传统自动评估指标如ROUGE无法充分反映人类对摘要质量的主观偏好,而opin-pref通过引入专家标注的偏好数据,为强化学习从人类反馈(RLHF)提供了可靠的监督信号。这一资源推动了奖励建模方法的进步,使模型能够在电商评论等复杂场景下学习到更符合人类直觉的摘要生成策略,显著提升了生成摘要的相关性、连贯性和信息覆盖度。
衍生相关工作
基于opin-pref数据集,研究者提出了多项创新性工作。Nath等人(2024)率先将其用于探索领域知识在高效奖励建模中的作用,验证了专家偏好数据在RLHF框架下的有效性。后续工作进一步拓展了该数据集的应用边界,包括多任务偏好学习、跨域摘要偏好迁移以及结合大语言模型的少样本偏好对齐方法。这些衍生研究不仅深化了对人类偏好建模的理解,也为构建更可靠、更可控的文本生成系统奠定了实证基础。
以上内容由遇见数据集搜集并总结生成


