
googlenews_vectors
收藏官方服务:
资源简介:
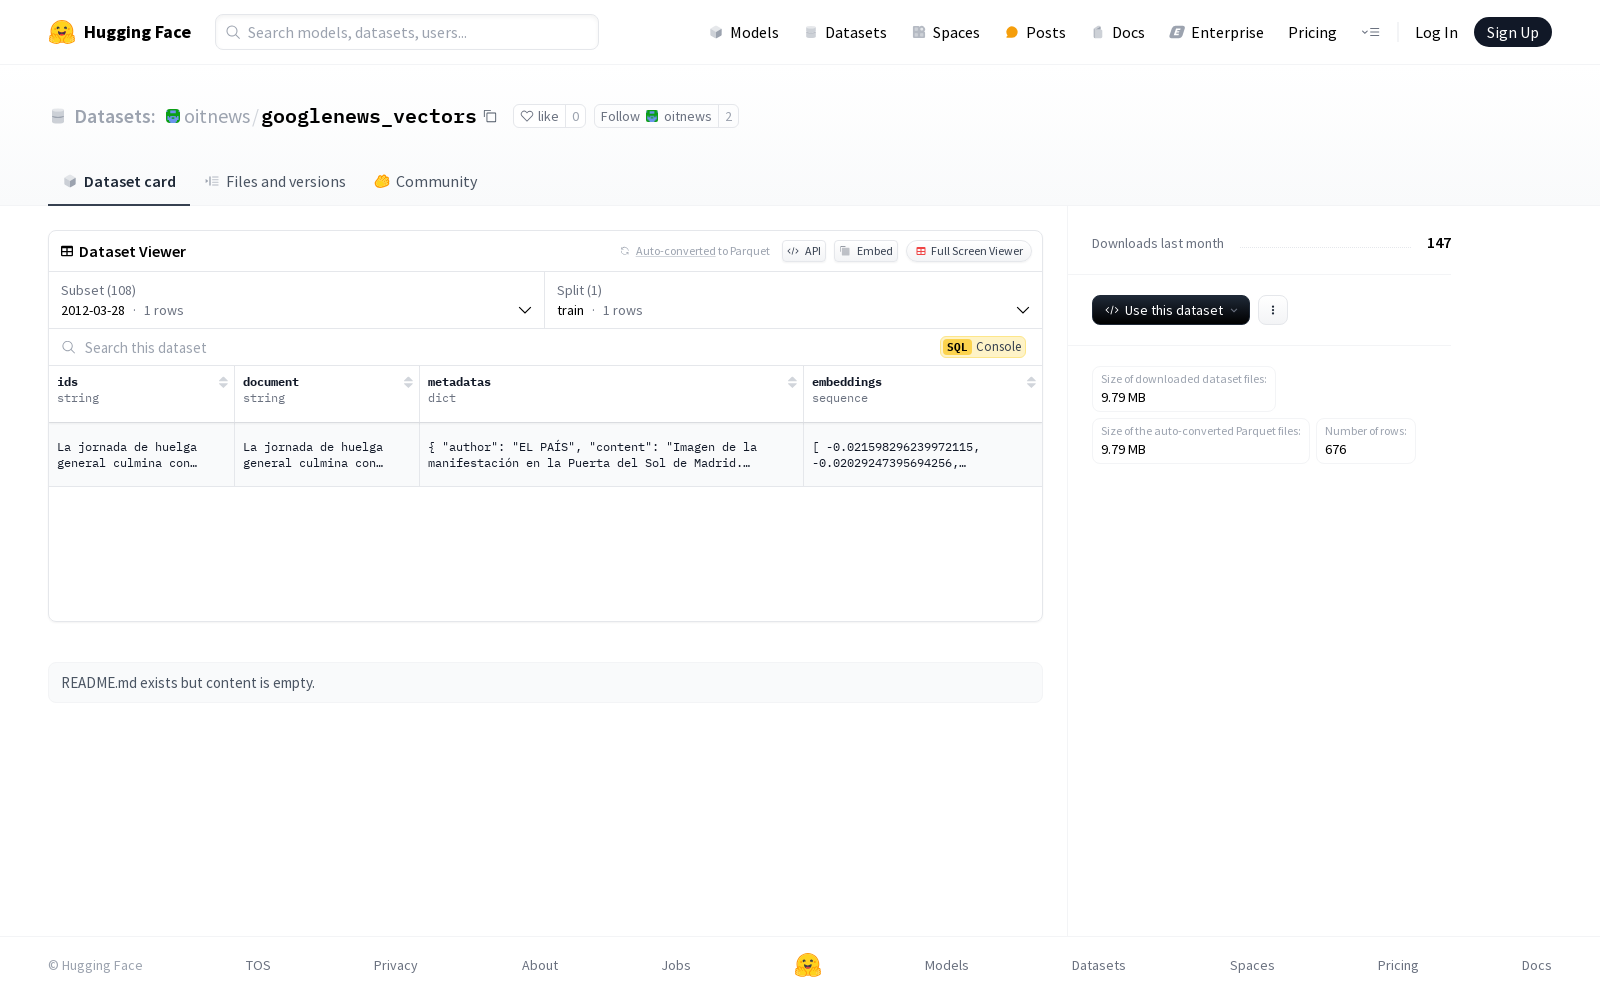
该数据集包含多个配置,每个配置以日期命名,包含文档的标识符、文档内容、元数据(如作者、内容、国家、描述、图片、链接、优先级、发布时间、来源、摘要、标题等)以及嵌入向量。数据集提供了每个配置的训练集大小、下载大小和示例数量。
This dataset contains multiple configurations, each named after a date. Each configuration includes document identifiers, document content, metadata (such as author, content, country, description, images, links, priority, release time, source, abstract, title, etc.), and embedding vectors. The dataset provides the training set size, download size, and number of examples for each configuration.
创建时间:
2024-12-11
原始信息汇总
Google News Vectors 数据集
概述
该数据集包含多个配置版本的Google News向量,每个配置版本对应一个特定的日期。每个配置版本包含以下内容:
- ids: 字符串类型,表示文档的唯一标识符。
- document: 字符串类型,表示文档内容。
- metadatas: 结构化数据,包含以下字段:
- author: 字符串类型,表示作者。
- content: 字符串类型,表示内容。
- country: 字符串类型,表示国家。
- description: 字符串类型,表示描述。
- image: 字符串类型,表示图片链接。
- link: 字符串类型,表示链接。
- priority: 字符串类型,表示优先级。
- published: 字符串类型,表示发布时间。
- source: 字符串类型,表示来源。
- summary: 字符串类型,表示摘要。
- title: 字符串类型,表示标题。
- embeddings: 序列类型,表示文档的嵌入向量,数据类型为float64。
数据集配置
每个配置版本包含一个训练集(train),训练集的大小和示例数量如下:
| 配置名称 | 训练集字节数 | 训练集示例数 | 下载大小 | 数据集大小 |
|---|---|---|---|---|
| 2012-03-28 | 25048 | 1 | 27974 | 25048 |
| 2016-05-30 | 17715 | 1 | 23676 | 17715 |
| 2016-05-31 | 22828 | 1 | 26089 | 22828 |
| 2017-01-20 | 15688 | 1 | 39911 | 15688 |
| 2017-06-23 | 21304 | 1 | 25710 | 21304 |
| 2017-10-10 | 13090 | 1 | 22424 | 13090 |
| 2017-10-11 | 13090 | 1 | 19875 | 13090 |
| 2017-10-12 | 13090 | 1 | 19875 | 13090 |
| 2018-04-21 | 17309 | 1 | 39899 | 17309 |
| 2018-05-05 | 14534 | 1 | 26570 | 14534 |
| 2018-08-06 | 13256 | 1 | 20695 | 13256 |
| 2019-01-22 | 13479 | 1 | 21833 | 13479 |
| 2019-02-18 | 19002 | 1 | 27052 | 19002 |
| 2019-03-11 | 19960 | 1 | 27664 | 19960 |
| 2019-04-11 | 12705 | 1 | 17885 | 12705 |
| 2019-06-19 | 19589 | 1 | 29288 | 19589 |
| 2019-09-11 | 13461 | 1 | 24929 | 13461 |
| 2019-10-02 | 13443 | 1 | 24633 | 13443 |
| 2019-12-04 | 19981 | 1 | 24328 | 19981 |
| 2020-02-19 | 13216 | 1 | 20469 | 13216 |
| 2020-03-07 | 23456 | 1 | 30165 | 23456 |
| 2020-09-18 | 22240 | 1 | 26148 | 22240 |
| 2021-03-09 | 16145 | 1 | 34305 | 16145 |
| 2021-05-06 | 18208 | 1 | 24383 | 18208 |
| 2021-07-11 | 13332 | 1 | 20930 | 13332 |
| 2022-01-11 | 13295 | 1 | 20792 | 13295 |
| 2022-01-12 | 13295 | 1 | 20792 | 13295 |
| 2022-03-04 | 13295 | 1 | 20792 | 13295 |
数据集大小
- 下载大小: 每个配置版本的下载大小不同,范围从17885字节到39911字节。
- 数据集大小: 每个配置版本的数据集大小不同,范围从12705字节到23456字节。
搜集汇总
数据集介绍
构建方式
googlenews_vectors数据集的构建基于多个时间点的Google新闻数据,涵盖了从2012年到2022年的多个日期版本。每个版本的数据集包含了新闻文章的详细元数据,如作者、内容、国家、描述、图片链接、优先级、发布时间、来源、摘要和标题等信息。此外,每篇文章还附带了对应的嵌入向量,这些向量以浮点数序列的形式存储,用于表示文章的语义特征。数据集的构建方式是通过定期抓取Google新闻的公开数据,并对其进行结构化处理,最终生成包含文本内容和嵌入向量的数据集。
特点
该数据集的主要特点在于其多时间点的版本控制和丰富的元数据信息。每个版本的数据集不仅包含了新闻文章的文本内容,还提供了详细的元数据,如作者、国家、发布时间等,这些信息为研究新闻传播、文本分析等领域提供了丰富的背景信息。此外,每篇文章的嵌入向量为文本的语义分析提供了强大的支持,使得该数据集在自然语言处理和机器学习任务中具有广泛的应用潜力。
使用方法
使用googlenews_vectors数据集时,用户可以根据需求选择特定时间点的数据版本,并利用其中的文本内容和嵌入向量进行各种自然语言处理任务,如文本分类、情感分析、语义相似度计算等。数据集的元数据部分可以用于构建更复杂的模型,例如基于新闻来源或发布时间的特征提取。此外,嵌入向量可以直接用于训练或评估文本表示模型,提升模型的语义理解能力。用户可以通过HuggingFace平台下载并加载该数据集,结合相应的深度学习框架进行模型训练和评估。
背景与挑战
背景概述
googlenews_vectors数据集是由多个时间点的Google新闻数据构成的,主要用于研究新闻文本的嵌入表示。该数据集的核心特征包括新闻文档的ID、内容、元数据(如作者、国家、发布时间等)以及嵌入向量。数据集的创建时间跨度从2012年到2022年,涵盖了多个版本,每个版本都包含了特定日期的新闻数据。这些数据为自然语言处理领域的研究提供了丰富的资源,尤其是在文本嵌入和语义表示方面,具有重要的应用价值。
当前挑战
googlenews_vectors数据集在构建过程中面临多个挑战。首先,新闻数据的时效性要求数据集必须定期更新,以确保其反映最新的新闻动态和语言变化。其次,新闻文本的多样性和复杂性使得嵌入向量的生成和质量评估变得复杂,尤其是在处理多语言和跨文化内容时。此外,数据集的规模和结构也带来了存储和处理上的挑战,尤其是在处理大规模嵌入向量时,如何高效地进行数据检索和分析是一个重要的技术难题。
常用场景
经典使用场景
GoogleNews Vectors数据集在自然语言处理领域中被广泛应用于词向量表示的学习与评估。其经典使用场景包括但不限于词义相似度计算、文本分类、信息检索以及语义分析等任务。通过预训练的词嵌入模型,该数据集能够捕捉词汇间的语义关系,从而提升各类自然语言处理任务的性能。
解决学术问题
GoogleNews Vectors数据集解决了传统词袋模型在处理自然语言时无法捕捉语义信息的局限性问题。通过学习大规模新闻文本中的词向量,该数据集为研究人员提供了一种高效的方式来表示词汇的语义特征,从而推动了词嵌入技术在学术界的广泛应用,尤其是在语义相似度计算和文本生成等领域。
衍生相关工作
基于GoogleNews Vectors数据集,许多后续研究工作得以展开,包括但不限于改进的词嵌入模型、跨语言词向量学习以及多模态语义表示等。这些工作进一步推动了词向量技术的发展,并在多个领域取得了显著的成果。例如,通过引入上下文信息,研究人员提出了BERT等预训练语言模型,极大地提升了自然语言处理任务的效果。
以上内容由遇见数据集搜集并总结生成


