
Linly-AI/Chinese-pretraining-dataset
收藏官方服务:
资源简介:
--- license: apache-2.0 --- Data source: https://github.com/CVI-SZU/Linly/wiki/Linly-OpenLLaMA
许可证:Apache-2.0 数据来源:https://github.com/CVI-SZU/Linly/wiki/Linly-OpenLLaMA
提供机构:
Linly-AI原始信息汇总
数据集概述
许可证
- 类型: Apache-2.0
数据源
- 链接: https://github.com/CVI-SZU/Linly/wiki/Linly-OpenLLaMA
搜集汇总
数据集介绍
构建方式
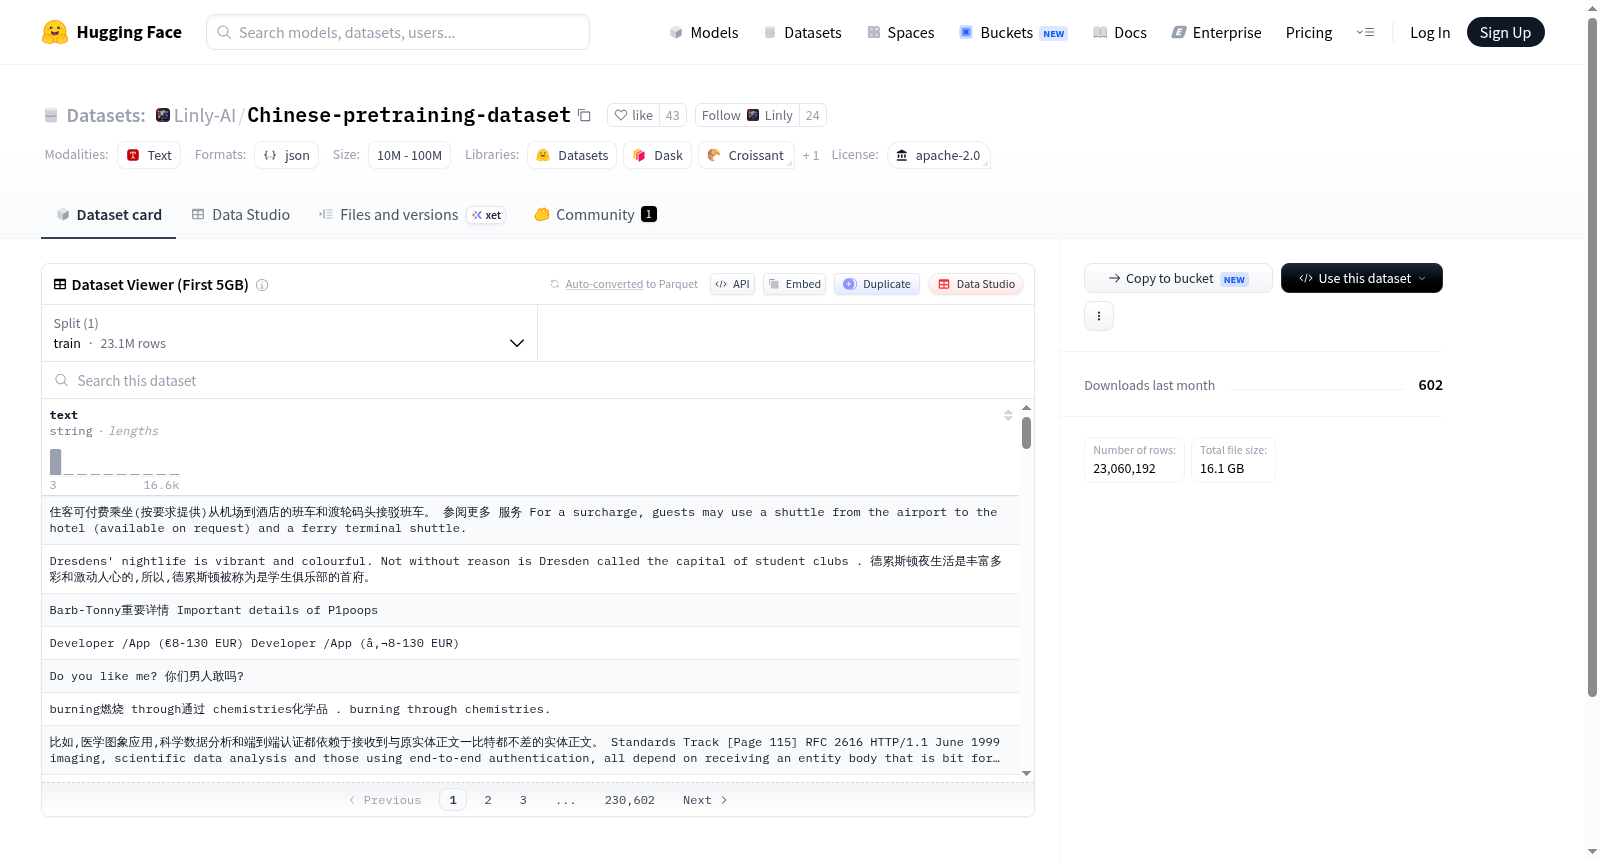
该数据集源自Linly项目,旨在为中文预训练语言模型提供高质量的大规模语料。构建过程中,团队从互联网公开资源中系统性地收集了海量中文文本,经过严格的清洗、去重与过滤,剔除了低质量、重复及有害内容,最终形成了涵盖新闻、百科、论坛、书籍等多领域的综合性预训练语料。
特点
数据集具有显著的多领域覆盖特性,囊括了新闻、百科、论坛、书籍等多种文本类型,确保了语言模型的泛化能力。其规模宏大,经过精细预处理后,语料质量高且噪声低,特别适合用于从零开始训练中文大语言模型或进行领域适应性的继续预训练。
使用方法
用户可直接通过HuggingFace平台加载该数据集,利用Datasets库中的`load_dataset`函数快速获取。推荐将其作为预训练阶段的核心语料,配合标准的分词与掩码策略使用。对于有特定领域需求的用户,可基于该数据集进行过滤或混合其他专用语料,以构建定制化的训练集。
背景与挑战
背景概述
大规模中文预训练语料库的构建是推动中文自然语言处理技术发展的关键基石。Linly-AI/Chinese-pretraining-dataset 由深圳大学计算机视觉研究所(CVI-SZU)团队于2023年创建,旨在为中文大语言模型提供高质量、多样化的预训练数据。该数据集的核心研究问题在于如何系统性地收集和整理海量中文文本,以支撑模型对中文语言结构、语义及文化背景的深度理解。作为 Linly-OpenLLaMA 项目的重要组成部分,该数据集为后续开源中文大模型的训练奠定了数据基础,显著促进了中文 NLP 领域的开放研究生态,成为相关学者和开发者不可或缺的资源之一。
当前挑战
该数据集面临的核心挑战首先在于中文语料的多样性与质量平衡问题。中文互联网内容繁杂,包含大量噪声、低质或重复文本,如何设计有效的清洗与过滤策略以保留高质量信息,同时覆盖新闻、百科、论坛等多元领域,是构建过程中的主要难点。其次,数据规模庞大带来的存储与处理效率问题不容忽视,如何在不牺牲数据代表性的前提下实现高效预处理与索引,对技术架构提出了更高要求。此外,版权与合规性也是持续挑战,需确保语料来源的合法性,避免侵权风险,这为数据集的持续更新与扩展设置了边界。
常用场景
经典使用场景
Linly-AI/Chinese-pretraining-dataset作为大规模中文预训练语料库,其经典使用场景在于为中文大型语言模型(LLM)的从头预训练提供基础数据支撑。该数据集汇聚了海量高质量的中文文本,覆盖新闻、百科、论坛、书籍等多源异构内容,能够有效捕捉中文语言的语法结构、语义特征及文化语境。研究者常将其应用于构建基础语言模型,例如在GPT、LLaMA等架构上开展预训练实验,以提升模型对中文文本的理解与生成能力。该数据集的规模与多样性使其成为中文NLP领域预训练任务的标杆性资源,尤其适用于需要大规模无监督学习的场景。
实际应用
在实际应用层面,该数据集预训练的模型可直接部署于智能客服、机器翻译、内容生成、情感分析等中文商业场景。例如,经过该语料预训练的语言模型可被微调后用于企业级对话系统,提供更符合中文用户表达习惯的交互体验;在新闻摘要或社交媒体分析中,模型能准确理解中文特有的修辞与情感色彩。此外,该数据集还支持教育领域的智能辅导、医疗领域的病历文本分析等垂直场景,通过迁移学习快速适配特定领域需求。其实际价值在于为中文AI产品提供了底层语言理解能力,显著降低了从零构建中文NLP系统的成本与时间。
衍生相关工作
该数据集衍生了一系列经典研究工作,最著名的是Linly-OpenLLaMA项目,其基于此数据集训练了中文版OpenLLaMA模型,验证了中文语料与LLaMA架构的适配性。后续工作包括利用该数据集进行知识蒸馏、模型压缩及多任务微调的研究,例如探索低资源语言模型在中文场景下的高效部署。此外,该数据集还催生了针对中文预训练策略的优化工作,如动态词表、领域自适应预训练等方法的提出。这些衍生研究不仅深化了对中文语言模型训练规律的理解,也为后续更大规模中文数据集(如WuDao、CPM系列)的构建提供了方法论参考,形成了持续演进的研究生态。
以上内容由遇见数据集搜集并总结生成


