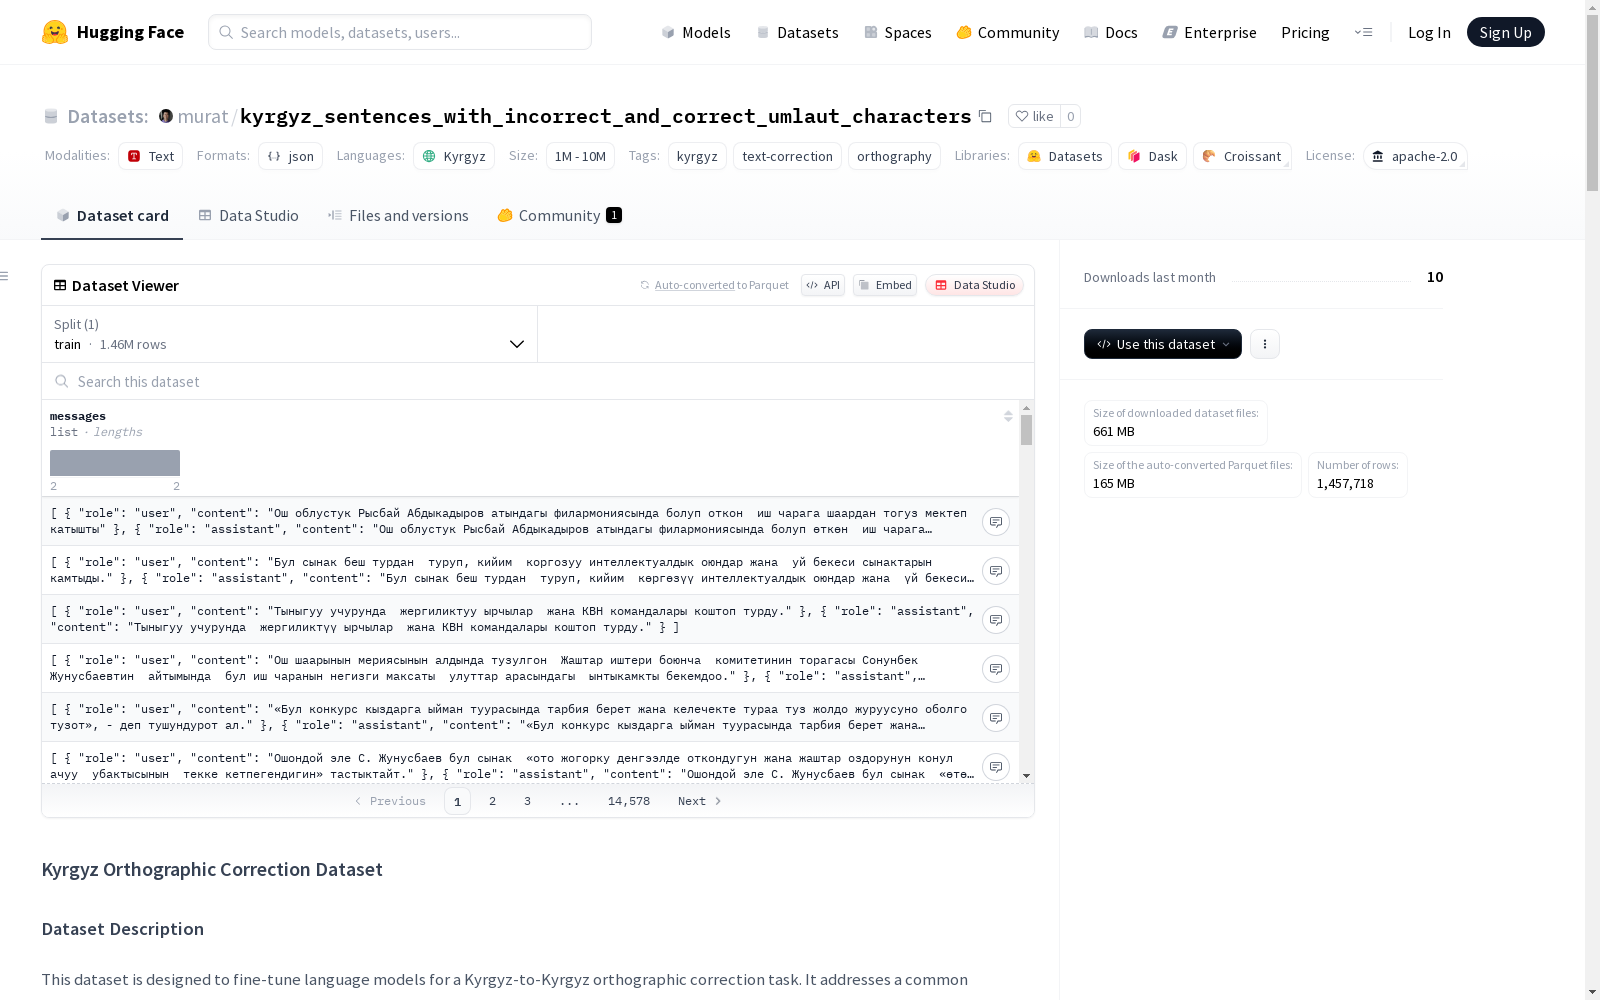
kyrgyz_sentences_with_incorrect_and_correct_umlaut_characters
收藏资源简介:
这个数据集旨在为 Kyrgyz-to-Kyrgyz 正字法纠正任务微调语言模型。它解决了数字 Kyrgyz 文本中一个常见问题,即 Kyrgyz 语言特定的西里尔字母 (ө, ң, ү) 被其俄语键盘对应物 (о, н, у) 替换。该数据集以对话格式构建,使其成为指令微调聊天模型的理想选择。
This dataset is designed for fine-tuning language models on the Kyrgyz-to-Kyrgyz orthographic correction task. It addresses a common issue in digital Kyrgyz text, where the Cyrillic letters specific to the Kyrgyz language (ө, ң, ү) are replaced by their Russian keyboard counterparts (о, н, у). The dataset is constructed in a conversational format, making it ideal for instruction-tuning chat models.
Kyrgyz Orthographic Correction Dataset 数据集概述
数据集基本信息
- 许可证: Apache-2.0
- 标签: kyrgyz, text-correction, orthography
- 语言: 柯尔克孜语 (ky)
- 名称: Kyrgyz sentences with incorrect and correct umlaut characters
数据集描述
该数据集专为柯尔克孜语到柯尔克孜语的拼写纠正任务而设计,用于微调语言模型。它解决了柯尔克孜语数字文本中的一个常见问题:特定于柯尔克孜语的西里尔字符(ө, ң, ү)被其俄语键盘对应字符(о, н, у)替换。
数据集采用对话格式构建,非常适合对聊天模型进行指令微调。
背景与动机
数据集创建的背景源于实际挑战:主流操作系统(如Windows和macOS)缺乏官方的柯尔克孜语本地化。因此,许多柯尔克孜斯坦用户使用带有俄语图形用户界面的操作系统,默认包含俄语键盘布局。
这导致用户经常在 unaware 有专用柯尔克孜语布局的情况下,使用俄语布局输入柯尔克孜语文本,从而造成一致的字符替换:
- о 被用来代替 ө
- н 被用来代替 ң
- у 被用来代替 ү
这种“错误”拼写在非正式数字通信中非常普遍,甚至大型语言模型(LLMs)有时也会重现这些错误。
数据集还解决了另一个重要的替换问题:西里尔字符 ё 被 е 替换。这通常源于现代俄语正字法惯例的影响。在当代俄语书写中,字母 ё 经常被 е 替换,但此做法被错误地应用于柯尔克孜语,导致拼写错误。
数据格式
数据集遵循对话提示格式,每个数据点都是一个包含消息列表的JSON对象。
json { "messages": [ {"role": "user", "content": "The sentence with potential character substitutions."}, {"role": "assistant", "content": "The corrected sentence with proper Kyrgyz characters."} ] }
数据字段
messages: 包含对话轮次的列表。role: 可以是 "user"(用于输入文本)或 "assistant"(用于纠正后的文本)。content: 文本字符串。
重要说明
请注意,并非所有句子都包含字符 ө, ң, ү, ё。如果原始句子在拼写上已经正确,"user" 和 "assistant" 的内容将完全匹配。
数据示例
json {"messages": [{"role": "user", "content": "Кардар кароолчунун жанынан отуп баратып аны мобилдик телефонго суротко тартып алган."}, {"role": "assistant", "content": "Кардар кароолчунун жанынан өтүп баратып аны мобилдик телефонго сүрөткө тартып алган."}]} {"messages": [{"role": "user", "content": "Мейманкана курулушуна каршыбыз."}, {"role": "assistant", "content": "Мейманкана курулушуна каршыбыз."}]}
引用信息
如果使用此数据集,请按以下格式引用:
bibtex @dataset{murat_jumashev_2025_kyrgyz_sentences_with_incorrect_and_correct_umlaut_characters, author = {Murat Jumashev}, title = {Kyrgyz Sentences with Incorrect and Correct Umlaut Characters}, month = {aug}, year = {2025}, publisher = {Hugging Face}, url = {https://huggingface.co/datasets/murat/kyrgyz_sentences_with_incorrect_and_correct_umlaut_characters} }