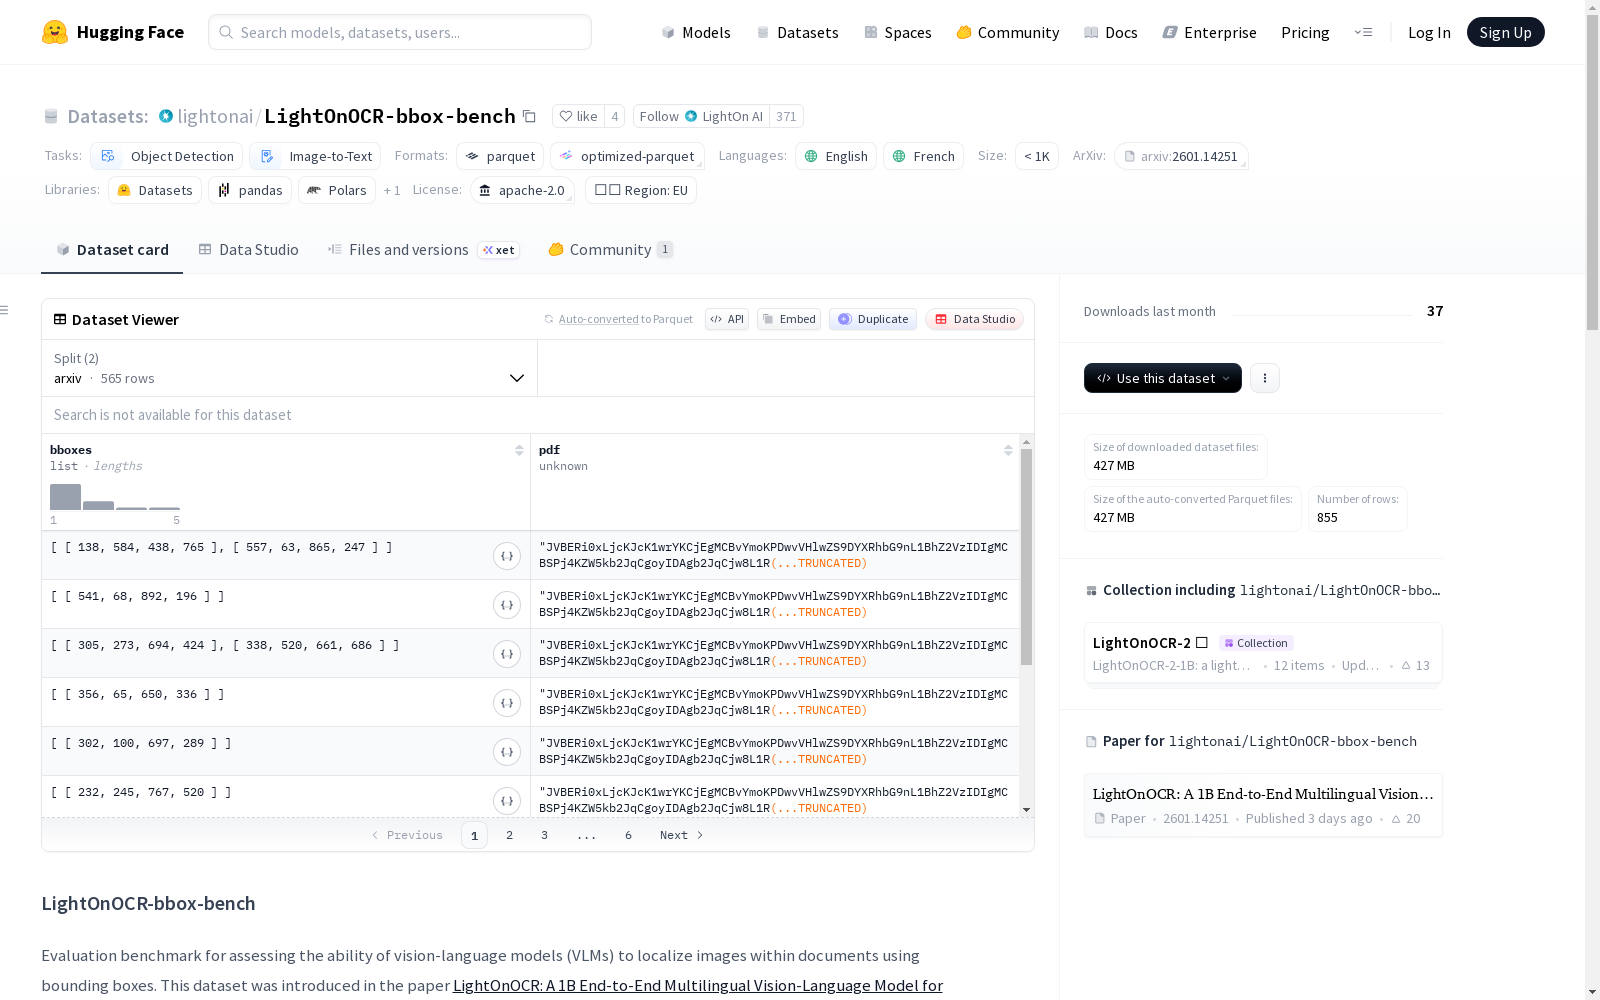
LightOnOCR-bbox-bench
收藏资源简介:
LightOnOCR-bbox-bench是一个评估视觉语言模型(VLMs)在文档中定位图像能力的基准数据集。该数据集在论文《LightOnOCR: A 1B End-to-End Multilingual Vision-Language Model for State-of-the-Art OCR》中提出。任务描述为:给定一个文档页面(PDF),模型必须预测文档中图像(如图表、照片等)的边界框。每个样本包含1-5个需要定位的图像,边界框坐标归一化到0-1000的空间。数据集包含两个子集:arxiv(565个科学论文样本)和olmocr_bench(290个多样化文档样本)。
LightOnOCR-bbox-bench 数据集概述
数据集简介
LightOnOCR-bbox-bench 是一个用于评估视觉语言模型在文档中定位图像能力的基准数据集。该数据集在论文《LightOnOCR: A 1B End-to-End Multilingual Vision-Language Model for State-of-the-Art OCR》中被提出。
任务描述
给定一个文档页面(PDF),模型需要预测文档中图像(如图表、照片等)的边界框。此任务评估模型的空间理解能力以及在复杂文档布局中区分视觉内容与文本的能力。每个样本包含1-5个需要定位的图像,其真实边界框坐标被归一化到0-1000的坐标空间。
数据集结构
数据划分
arxiv:包含565个来自科学论文的样本。olmocr_bench:包含290个来自多样化文档类型的样本。
数据列
bboxes:边界框列表,格式为[x1, y1, x2, y2],坐标已归一化到0-1000空间。pdf:单页PDF文件,以字节形式存储。
数据集构成
ArXiv 子集(565个样本)
- 来源:arXiv的科学论文。
- 内容:包含图表、示意图等的科学论文。
- 标注:使用nvpdftex工具包自动标注。
- 筛选:每页包含1-5个图像。
OlmOCR 子集(290个样本)
- 来源:源自
allenai/olmOCR-bench数据集。 - 内容:多样化文档类型,包括数学论文、表格、多栏布局和历史扫描件。
- 筛选:每页包含1-5个图像,并排除了仅包含徽标的样本。
使用方式
可通过 datasets 库加载数据集。加载后,可访问样本的 bboxes 和 pdf 字段。需要将归一化的边界框坐标(0-1000)根据渲染后的图像尺寸转换为像素坐标。
引用信息
如果使用此数据集,请引用以下论文: bibtex @misc{lightonocr2_2026, title = {LightOnOCR: A 1B End-to-End Multilingual Vision-Language Model for State-of-the-Art OCR}, author = {Said Taghadouini and Adrien Cavaill`{e}s and Baptiste Aubertin}, year = {2026}, howpublished = {url{https://arxiv.org/pdf/2601.14251}} }
元数据
- 支持语言:英语(en)、法语(fr)。
- 许可证:Apache 2.0。
- 规模类别:n<1K。
- 任务类别:目标检测、图像到文本。