遇见数据集

Cleanlab/databricks-dolly-15k-cleanset

收藏
Hugging Face2024-02-19 更新2024-03-04 收录
官方服务:

资源简介:

`databricks-dolly-15k-cleanset`是一个用于清理和提高`databricks-dolly-15k`数据集质量的工具,该数据集原本包含15,000个人类注释的指令-响应对。通过使用Cleanlab Studio,此数据集新增了多个数据质量度量列,包括信任度分数、个人识别信息严重性、非正式语言严重性、非英语文本严重性和有害语言严重性。用户可以利用这些分数自动或手动过滤掉低质量的数据点,从而得到一个更干净、更适用于LLM微调的数据集。

`databricks-dolly-15k-cleanset`是一个用于清理和提高`databricks-dolly-15k`数据集质量的工具,该数据集原本包含15,000个人类注释的指令-响应对。通过使用Cleanlab Studio,此数据集新增了多个数据质量度量列,包括信任度分数、个人识别信息严重性、非正式语言严重性、非英语文本严重性和有害语言严重性。用户可以利用这些分数自动或手动过滤掉低质量的数据点,从而得到一个更干净、更适用于LLM微调的数据集。

提供机构:
Cleanlab
原始信息汇总

数据集概述

databricks-dolly-15k-cleanset 是一个用于生成 databricks-dolly-15k 数据集的清洁版本的工具。原始的 databricks-dolly-15k 数据集包含 15,000 个人工标注的指令-响应对,涵盖多种类别。然而,该数据集中存在许多低质量的响应、不完整或模糊的提示以及其他有问题的文本。为了自动检测原始数据集中的低质量数据点,我们使用了 Cleanlab Studio。

新增列

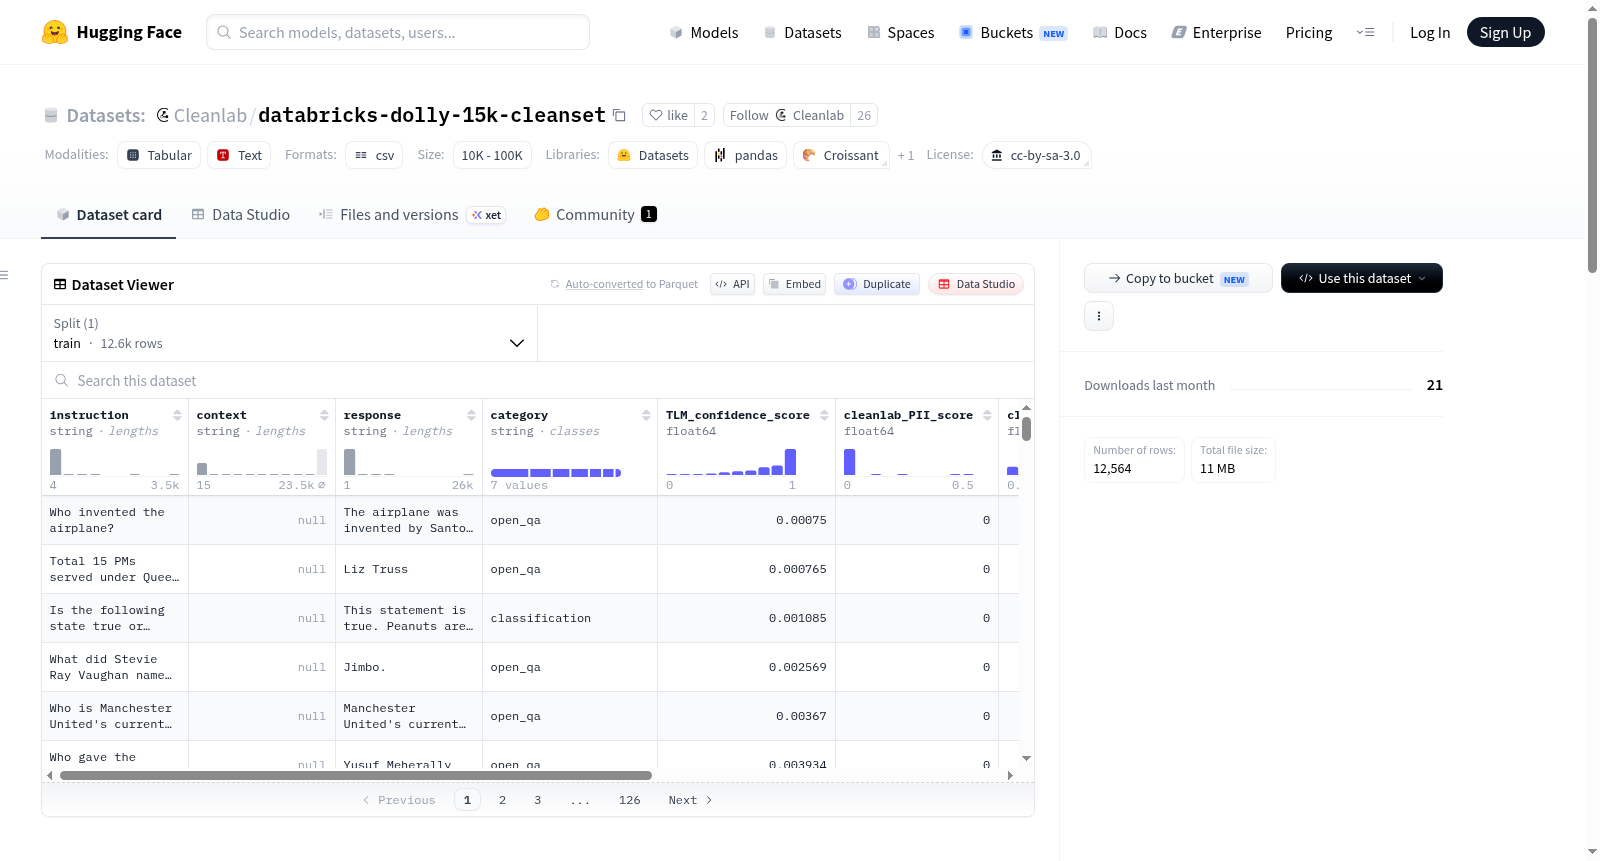
databricks-dolly-15k-cleanset 在原始数据集基础上新增了以下列,这些列是 Cleanlab 提供的各种数据质量指标:

  • TLM_confidence_score: 衡量对给定提示的响应的可信度(包括 aleatoric 和 epistemic 不确定性)。取值范围为 0 到 1,较低的值表示响应不太可能是好的。
  • cleanlab_PII_score: 衡量文本中个人识别信息(PII)的出现频率和严重程度。取值范围为 0 到 1,较高的值表示更严重的程度。
  • cleanlab_informal_score: 衡量文本中非正式语言、俚语或糟糕写作的出现频率和严重程度。取值范围为 0 到 1,较高的值表示更严重的程度。
  • cleanlab_non_english_score: 衡量文本中非英语语言或无意义字符(如 HTML/XML 标签、标识符、哈希、随机字符)的出现频率。取值范围为 0 到 1,较高的值表示更严重的程度。
  • cleanlab_toxic_score: 衡量文本中仇恨言论和有害语言的出现频率和严重程度。取值范围为 0 到 1,较高的值表示更严重的程度。

使用方法

通过新增的列,用户可以过滤掉低质量的数据点,生成更清洁的数据集。用户可以手动审查具有问题分数的数据点并替换为更高质量的指令/响应,或者设定阈值自动剔除不符合要求的数据点。

示例代码

以下是使用 Python 过滤低质量数据点的示例代码:

python import pandas as pd

加载数据集

df = pd.read_csv(databricks-dolly-15k-cleanset.csv)

设定阈值

TLM_confidence_score_threshold = 0.5 PII_score_threshold = 0.4 informal_score_threshold = 0.6 non_english_score_threshold = 0.8 toxic_score_threshold = 0.95

过滤数据点

cleaned_df = df[ (df[TLM_confidence_score] > TLM_confidence_score_threshold) & (df[cleanlab_PII_score] < PII_score_threshold) & (df[cleanlab_informal_score] < informal_score_threshold) & (df[cleanlab_non_english_score] < non_english_score_threshold) & (df[cleanlab_toxic_score] < toxic_score_threshold) ]

删除分数列

columns_to_drop = [TLM_confidence_score, cleanlab_PII_score, cleanlab_informal_score, cleanlab_toxic_score, cleanlab_non_english_score] cleaned_df = cleaned_df.drop(columns=columns_to_drop)

保存清洁后的数据集

cleaned_df.to_csv(databricks-dolly-15k-cleaned.csv, index=False)

清洁版本数据集

我们提供了一个清洁版本的 databricks-dolly-15k 数据集: databricks-dolly-15k-cleaned.csv
搜集汇总
数据集介绍
Cleanlab/databricks-dolly-15k-cleanset 数据集图片
构建方式
在指令微调大语言模型的实践中,数据质量是决定模型性能的关键因素。Cleanlab/databricks-dolly-15k-cleanset 数据集正是针对这一痛点而构建,它基于广受欢迎的 databricks-dolly-15k 数据集进行质量清洗与增强。构建过程中,研究者利用 Cleanlab Studio 自动检测原始数据中的低质量样本,为每条指令-响应对附加了多维度的数据质量评分指标,包括响应可信度、个人身份信息严重程度、非正式语言程度、非英语文本程度以及有害内容程度,从而形成一份带有质量标注的增强版数据集。
特点
该数据集的核心特色在于其精细化的质量评估体系。通过引入 TLM 置信度分数与五项 Cleanlab 文本问题评分,为每个数据点提供了从语义可信度到文本规范性、从语言纯洁性到安全性的全方位量化标尺。这些分数不仅反映了响应与提示之间的内在一致性,还能有效识别包含敏感信息、俚语表达、外文干扰或恶意内容的低质量样本。这种多维度的质量标注机制,使得研究者能够根据具体需求灵活筛选数据,从而在保留高质量样本的同时,系统性地剔除噪声与有害内容。
使用方法
使用该数据集时,研究者可通过设定各质量指标的阈值来实现自动化数据清洗。例如,基于响应可信度分数设定下限阈值,同时为各类文本问题分数设定上限阈值,即可快速筛选出满足质量要求的数据子集。这一过程可通过简单的 Pandas 操作完成,筛选后还可移除质量评分列,获得纯净版的指令微调数据集。此外,对于分数异常的样本,研究者亦可进行人工审查与替换,进一步优化数据质量。该数据集为指令微调任务提供了一种高效、可复现的数据质量控制方案。
背景与挑战
背景概述
在大型语言模型(LLM)的指令微调领域,高质量数据集的构建是提升模型性能的关键基石。2023年,Databricks团队发布了Dolly 2.0,并随之推出了databricks-dolly-15k数据集,该数据集包含15,000条由人工标注的指令-响应对,覆盖了多种任务类别,旨在推动开源、商业可用的指令微调模型发展。然而,现实世界的数据标注不可避免地引入噪声,如低质量响应、模糊指令或潜在的有害内容,这成为制约模型训练效果的瓶颈。为此,Cleanlab团队在2024年对该数据集进行了系统性质量清洗,创建了databricks-dolly-15k-cleanset。该版本通过Cleanlab Studio自动检测并标记出数据点中的可信度、个人身份信息(PII)、非正式语言、非英语内容及毒性文本等维度的问题,为研究人员提供了一套可量化的数据质量评估工具,显著提升了指令微调数据的可靠性与可用性。
当前挑战
该数据集面临的核心挑战源于指令微调数据固有的质量异质性。首先,原始databricks-dolly-15k中大量指令-响应对存在质量缺陷,包括响应内容不完整、提示模糊或逻辑矛盾,这些低质量样本会误导模型学习,导致微调后的LLM生成不可靠输出。其次,数据构建过程中难以避免的噪声问题,如部分响应包含个人身份信息(PII)、非正式俚语或非英语字符,甚至出现有害言论,这些内容不仅降低训练效率,还可能引发伦理与安全风险。此外,传统人工清洗方法成本高昂且主观性强,难以规模化应用。Cleanlab团队通过引入自动化质量评分体系,精准识别并量化上述问题,但如何设定合理的阈值以平衡数据保留量与纯净度,仍是实际应用中的关键挑战。
常用场景
经典使用场景
在指令微调大型语言模型的学术探索中,数据质量常成为制约模型性能的关键瓶颈。Cleanlab/databricks-dolly-15k-cleanset作为对原始databricks-dolly-15k数据集的质量增强版本,通过引入多维度的置信度与文本问题评分,为研究者提供了一种系统性的数据清洗框架。该数据集最经典的使用场景在于,研究者可依据TLM置信度分数以及PII、非正式语言、非英语内容、毒性内容等专项评分,设定阈值以自动过滤低质量样本,从而获得更纯净的指令-响应对集合。这一过程不仅提升了微调数据的整体可靠性,也为后续模型训练奠定了更稳健的数据基础。
实际应用
在实际产业应用中,该数据集为构建安全、合规且高效的对话系统提供了关键支撑。企业可利用PII评分自动过滤包含个人身份信息的样本,规避隐私泄露风险;通过毒性评分剔除仇恨言论,确保模型输出符合伦理规范;借助非正式语言评分优化客服机器人的专业度。此外,开发者可结合TLM置信度分数优先保留高可信度的训练样本,从而在有限资源下实现更高效的模型迭代。这种基于多维质量评分的自动化数据筛选方案,已广泛应用于金融、医疗、教育等对数据质量要求严苛的垂直领域。
衍生相关工作
该数据集衍生了一系列数据质量驱动的语言模型优化工作。最具代表性的是Cleanlab团队开源的配套代码库,展示了如何用简洁代码复现清洗流程,降低了数据净化技术的使用门槛。后续研究者在此基础上探索了自适应阈值选择算法,以及将质量评分作为样本权重进行加权微调的方法。此外,该工作启发了针对其他大规模指令数据集(如Alpaca、ShareGPT)的类似清洗方案,推动了“数据质量即模型性能”这一理念在开源社区中的普及。这些衍生工作共同构建了从数据诊断到模型优化的完整技术链条。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务