
culturax-10M
收藏官方服务:
资源简介:
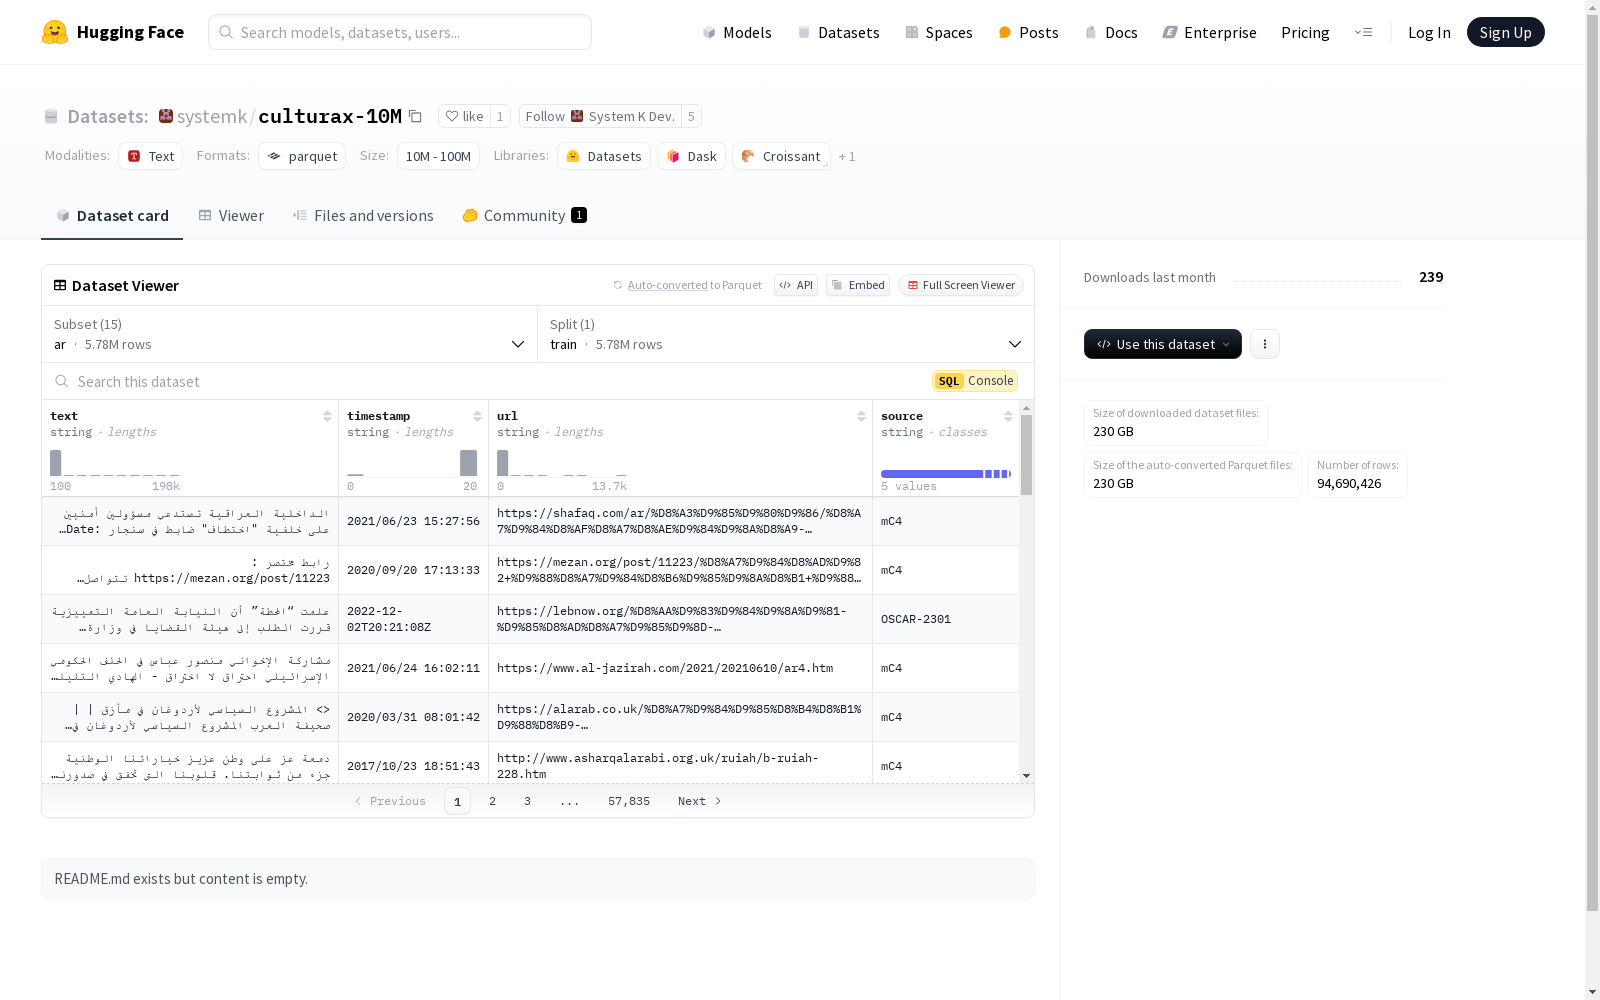
该数据集是一个多语言文本数据集,包含多种语言的文本数据,每种语言都有对应的配置信息。每个配置包含文本、时间戳、URL和来源四个特征。数据集分为训练集,并提供了每个语言配置的训练集的字节数和样本数,以及下载大小和数据集大小。
This is a multilingual text dataset containing text data in multiple languages, with each language having its corresponding configuration. Each configuration includes four features: text, timestamp, URL, and source. The dataset is divided into training sets, and provides the byte count, sample count of the training set for each language configuration, as well as the download size and the dataset size.
创建时间:
2024-11-27
原始信息汇总
Culturax-10M 数据集概述
数据集配置
语言配置
- ar: 阿拉伯语
- bn: 孟加拉语
- de: 德语
- en: 英语
- es: 西班牙语
- fr: 法语
- hi: 印地语
- id: 印度尼西亚语
- ja: 日语
- mr: 马拉地语
- pt: 葡萄牙语
- ru: 俄语
- sw: 斯瓦希里语
- ur: 乌尔都语
- zh: 中文
特征
- text: 文本内容,数据类型为
string - timestamp: 时间戳,数据类型为
string - url: 链接地址,数据类型为
string - source: 来源,数据类型为
string
数据分割
- train: 训练集
数据集大小
阿拉伯语 (ar)
- 训练集样本数: 5,783,423
- 下载大小: 15,931,057,798 字节
- 数据集大小: 32,503,751,002 字节
孟加拉语 (bn)
- 训练集样本数: 6,909,220
- 下载大小: 17,081,881,608 字节
- 数据集大小: 45,429,520,708 字节
德语 (de)
- 训练集样本数: 8,203,422
- 下载大小: 18,958,419,080 字节
- 数据集大小: 30,513,989,404 字节
英语 (en)
- 训练集样本数: 10,602,308
- 下载大小: 24,556,018,136 字节
- 数据集大小: 39,890,392,561 字节
西班牙语 (es)
- 训练集样本数: 8,807,365
- 下载大小: 19,805,902,665 字节
- 数据集大小: 32,166,515,318 字节
法语 (fr)
- 训练集样本数: 7,104,566
- 下载大小: 15,531,078,641 字节
- 数据集大小: 25,504,763,210 字节
印地语 (hi)
- 训练集样本数: 6,145,407
- 下载大小: 17,659,815,232 字节
- 数据集大小: 46,111,940,293 字节
印度尼西亚语 (id)
- 训练集样本数: 7,266,054
- 下载大小: 11,042,734,413 字节
- 数据集大小: 19,717,564,473 字节
日语 (ja)
- 训练集样本数: 6,949,272
- 下载大小: 18,199,982,240 字节
- 数据集大小: 32,292,048,542 字节
马拉地语 (mr)
- 训练集样本数: 2,266,588
- 下载大小: 6,934,243,219 字节
- 数据集大小: 18,199,487,216 字节
葡萄牙语 (pt)
- 训练集样本数: 9,910,920
- 下载大小: 19,521,770,455 字节
- 数据集大小: 31,417,320,401 字节
俄语 (ru)
- 训练集样本数: 5,203,838
- 下载大小: 16,824,743,733 字节
- 数据集大小: 33,750,527,864 字节
斯瓦希里语 (sw)
- 训练集样本数: 66,506
- 下载大小: 72,716,390 字节
- 数据集大小: 131,276,561 字节
乌尔都语 (ur)
- 训练集样本数: 2,757,279
- 下载大小: 8,222,891,715 字节
- 数据集大小: 17,164,327,772 字节
中文 (zh)
- 训练集样本数: 6,832,052
- 下载大小: 20,048,176,249 字节
- 数据集大小: 28,768,720,767 字节
搜集汇总
数据集介绍
构建方式
culturax-10M数据集通过多语言文本的收集与整理构建而成,涵盖了阿拉伯语、孟加拉语、德语、英语、西班牙语、法语、印地语、印尼语、日语、马拉地语、葡萄牙语、俄语、斯瓦希里语、乌尔都语和中文等多种语言。每个语言配置均包含文本、时间戳、URL和来源等特征,数据以训练集的形式存储,确保了数据的多样性和广泛性。数据集的构建过程注重来源的多样性和时间跨度的覆盖,以反映不同语言和文化背景下的文本特征。
特点
culturax-10M数据集以其多语言覆盖和丰富的文本特征著称。每个语言配置均包含大量文本数据,例如英语配置包含超过1000万条文本,而中文配置也包含近700万条文本。数据集中的每条记录均附有时间戳和来源信息,便于用户进行时间序列分析和来源验证。此外,数据集的规模庞大,总数据量达到数百GB,为自然语言处理任务提供了充足的训练资源。
使用方法
culturax-10M数据集适用于多语言自然语言处理任务,如机器翻译、文本分类和语言模型训练。用户可通过HuggingFace平台下载特定语言配置的数据文件,数据以分片形式存储,便于高效加载和处理。使用该数据集时,建议根据任务需求选择相应的语言配置,并结合时间戳和来源信息进行数据筛选和预处理。数据集的分片设计支持大规模并行处理,适合在分布式计算环境中使用。
背景与挑战
背景概述
culturax-10M数据集是一个多语言文本数据集,涵盖了阿拉伯语、孟加拉语、德语、英语、西班牙语、法语、印地语、印尼语、日语、马拉地语、葡萄牙语、俄语、斯瓦希里语、乌尔都语和中文等多种语言。该数据集由多个研究机构联合创建,旨在为自然语言处理领域提供丰富的多语言文本资源,支持跨语言文本分析、机器翻译、语言模型训练等研究任务。其创建时间可追溯至近年,反映了全球范围内对多语言数据需求的日益增长。culturax-10M的出现为多语言研究提供了重要的数据支持,推动了跨语言技术的发展和创新。
当前挑战
culturax-10M数据集在构建和应用过程中面临多重挑战。首先,多语言数据的收集和清洗需要处理不同语言的语法、词汇和文化差异,确保数据的准确性和代表性。其次,数据规模庞大,存储和传输成本高,对计算资源提出了较高要求。此外,数据的时间戳和来源信息需要精确标注,以支持时间序列分析和数据溯源研究。在应用层面,如何有效利用多语言数据进行跨语言模型训练和优化,仍是一个亟待解决的技术难题。这些挑战不仅考验了数据集的构建能力,也对后续的研究和应用提出了更高的要求。
常用场景
经典使用场景
culturax-10M数据集在多语言自然语言处理领域具有广泛的应用,特别是在跨语言文本分析、机器翻译和语言模型训练中。该数据集涵盖了多种语言的文本数据,为研究人员提供了丰富的语料资源,能够支持大规模的语言模型训练和跨语言任务的实验。
实际应用
在实际应用中,culturax-10M数据集被广泛用于构建多语言搜索引擎、跨语言信息检索系统以及多语言聊天机器人。其丰富的语料资源能够提升这些系统在不同语言环境下的表现,满足全球化应用的需求。
衍生相关工作
基于culturax-10M数据集,许多经典的多语言NLP模型和算法得以开发。例如,跨语言BERT模型的训练、多语言机器翻译系统的优化以及低资源语言的自然语言理解任务,均受益于该数据集提供的多样化语料支持。
以上内容由遇见数据集搜集并总结生成


