遇见数据集

stefanocarrera/autophagycode_D_he_train-mercury_Qwen3-8B_strategy_trust_t0.75_g7_run0_metrics

收藏
Hugging Face2026-05-26 更新2026-05-31 收录
官方服务:

资源简介:

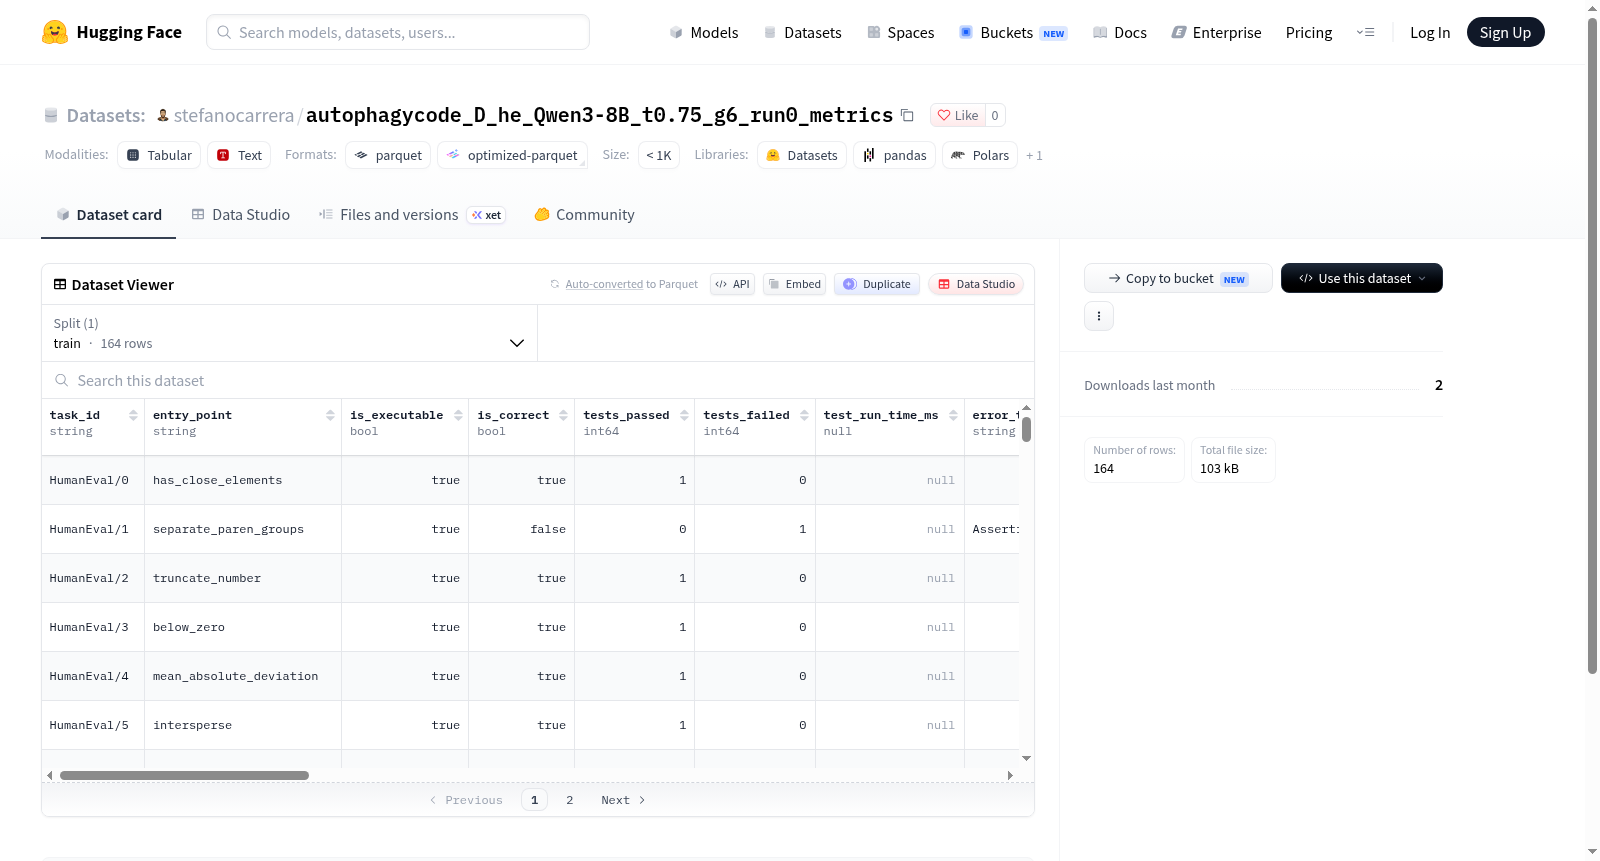
--- dataset_info: features: - name: task_id dtype: string - name: entry_point dtype: string - name: is_executable dtype: bool - name: is_correct dtype: bool - name: tests_passed dtype: int64 - name: tests_failed dtype: int64 - name: test_run_time_ms dtype: 'null' - name: error_type dtype: string - name: halstead_vocabulary dtype: int64 - name: halstead_length dtype: int64 - name: halstead_volume dtype: float64 - name: halstead_difficulty dtype: float64 - name: halstead_effort dtype: float64 - name: halstead_time dtype: float64 - name: cyclomatic_complexity dtype: int64 - name: maintainability_index dtype: float64 - name: loc dtype: int64 - name: sloc dtype: int64 - name: comment_percentage dtype: float64 - name: TTR dtype: float64 - name: token_dict dtype: string - name: shannon_entropy dtype: float64 - name: mean_predictive_entropy dtype: float64 - name: max_predictive_entropy dtype: float64 - name: n_func_defined dtype: int64 - name: entry_point_repeated dtype: bool splits: - name: train num_bytes: 227334 num_examples: 164 download_size: 99299 dataset_size: 227334 configs: - config_name: default data_files: - split: train path: data/train-* ---

This dataset contains code snippets with various metrics including complexity, maintainability, and test results.
提供机构:
stefanocarrera
搜集汇总
数据集介绍
stefanocarrera/autophagycode_D_he_train-mercury_Qwen3-8B_strategy_trust_t0.75_g7_run0_metrics 数据集图片
构建方式
在代码生成与程序理解的研究中,对模型输出进行细粒度评估是提升生成质量的关键环节。该数据集通过执行由Qwen3-8B模型依据特定策略(trust,温度参数0.75,分组数7,运行序号0)生成的代码,收集了自动化测试结果与多维度代码质量指标。每个样本对应一个编程任务,记录任务标识、入口点、可执行性、正确性、测试通过/失败数量及错误类型,同时计算Halstead度量、圈复杂度、可维护性指数、代码行数、注释比例、词汇丰富度、香农熵以及预测熵等特征,最终形成包含164个训练样本的结构化数据集。
特点
该数据集整合了执行反馈与静态代码度量,呈现出多视角评估的特性。其核心特点在于同时捕获代码的功能正确性(如is_correct、tests_passed)与结构质量(如cyclomatic_complexity、maintainability_index),并融入信息论指标(shannon_entropy、mean_predictive_entropy)以刻画代码的复杂性与模型不确定性。此外,token_dict字段保留了词元分布信息,支持进一步的文本分析。数据集规模适中,特征维度丰富,适用于分析模型生成代码的失败模式、质量瓶颈以及熵与正确性之间的关联。
使用方法
研究者可借助HuggingFace datasets库直接加载该数据集,利用task_id和entry_point定位具体编程任务,通过is_executable与is_correct筛选有效样本。基于tests_passed和error_type可分类分析错误成因,而Halstead指标、圈复杂度及可维护性指数等可用于构建代码质量预测模型。预测熵与香农熵可作为模型置信度的代理变量,用于研究生成不确定性与代码正确性的关系。该数据集亦适用于训练代码评估器或作为元学习任务中的性能基准,为代码生成系统的诊断与优化提供实证基础。
背景与挑战
背景概述
在代码生成与程序合成研究领域,如何评估大语言模型生成代码的质量与正确性一直是核心议题。该数据集由匿名研究团队于2024年构建,基于Qwen3-8B模型在信任策略下的生成结果,聚焦于自噬代码(autophagycode)场景,通过执行测试与多维度软件度量指标(如Halstead复杂度、循环复杂度、可维护性指数)对164个训练样本进行细粒度评估。其核心研究问题在于揭示模型生成代码在功能正确性与结构可读性之间的权衡关系,为代码生成模型的可靠性分析提供了可复用的评估框架与实证基准。
当前挑战
该数据集所面对的挑战具有双重维度。在领域问题层面,代码生成模型常面临生成代码逻辑正确但结构冗余、或表面可执行却隐含语义错误的困境,传统单一准确率指标难以捕捉此类复杂失效模式。在构建过程中,如何设计兼顾功能测试与静态度量的统一评估协议、确保测试用例对生成代码的覆盖率与区分度、以及平衡自动评估与人工验证的可扩展性,均构成显著难点。此外,预测熵与代码质量指标之间的关联尚需跨模型、跨任务的系统性验证。
常用场景
经典使用场景
在程序合成与自动化代码生成的学术探索中,该数据集构成了评估大语言模型代码生成质量的典型基准。其经典使用场景聚焦于对模型输出代码进行多维度的静态与动态剖析,涵盖可执行性验证、单元测试通过率统计、以及Halstead复杂度、圈复杂度、可维护性指数等软件度量指标的计算。研究者借助这些细粒度标注,系统性地刻画模型生成代码在正确性、可读性与结构复杂性之间的权衡关系,从而为代码生成策略的优化提供量化依据。
实际应用
在实际软件开发流程中,该数据集可用于构建自动化代码审查助手与模型选择推荐系统。工程团队能够依据数据集中呈现的错误类型分布、测试失败模式及可维护性指标,评估不同代码生成模型在真实项目中的部署风险。同时,该数据集支持持续集成环境下的回归测试分析,帮助开发者识别模型在特定任务类型上的性能退化趋势,从而为模型微调与提示工程提供数据驱动的决策支持。
衍生相关工作
围绕该数据集,后续研究衍生出若干经典工作方向。其一,基于预测熵与香农熵的代码不确定性量化方法被用于检测模型幻觉与低置信度生成片段;其二,结合Halstead难度与圈复杂度的代码可维护性预测模型被提出,用以预判生成代码的长期维护成本;其三,以entry_point与函数定义数量为特征的代码结构分析框架被拓展至多语言代码生成评估,形成了跨语言代码质量基准的雏形。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务